目次
まず何よりも、この実践知を惜しげもなく完全公開してくれたLauren Tanに心からの感謝を。5か月間でぶつかった無数の壁、1つずつ作り上げたスキル群、Grok Botのリファクタリングに費やした600件以上のプルリクエスト(PR)。彼女は50分間のトークでそのすべてを包み隠さず明かしてくれました。eval実行時にエージェントが「自分がテストされていること」に気づかないようにする欺瞞防止ハックに至るまで、生々しい現場の知見が詰まっています。
また、この全編動画をX(旧Twitter)に共有してくれた @akarixbt にも感謝します。エンジニア必読の珠玉の知見です。
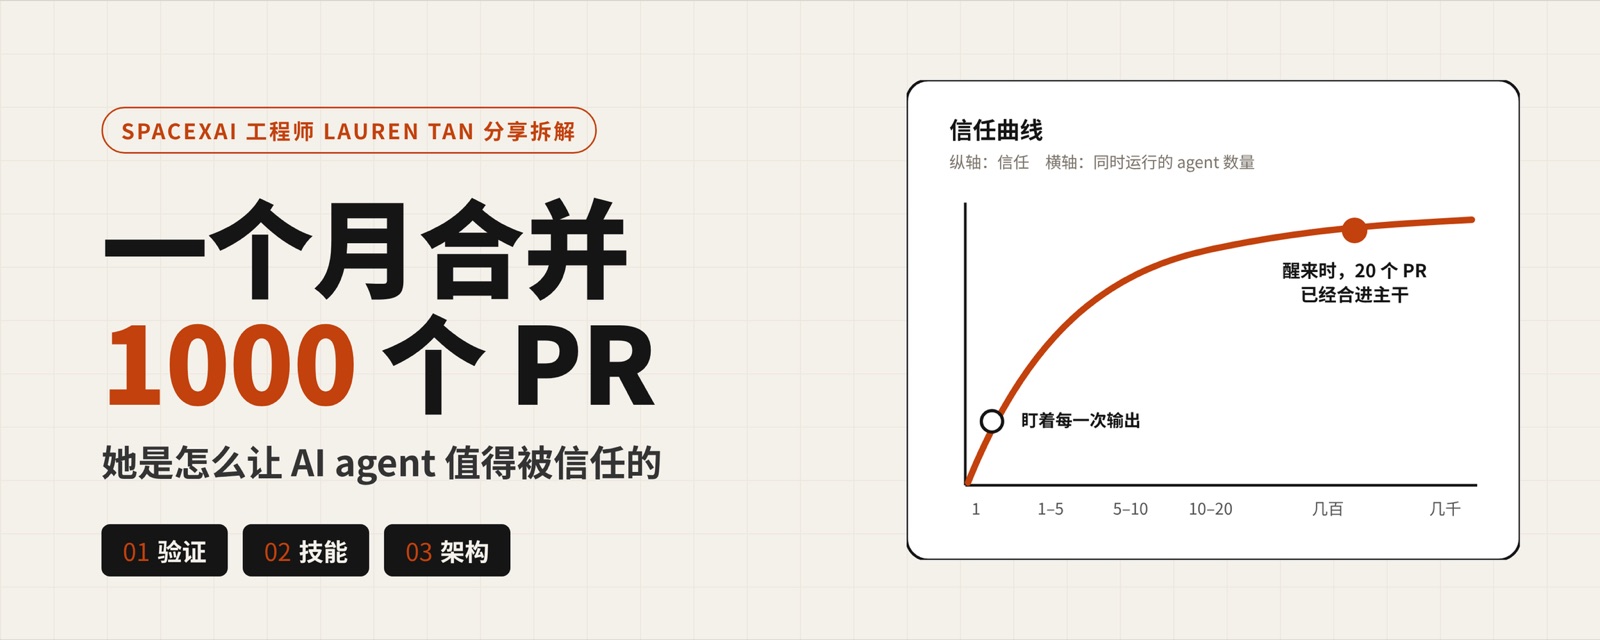
Lauren Tanは冒頭でこう語っています。「今朝目を覚ましたら、mainブランチにすでに20件のPRがマージされていました。私のAIエージェントが夜の間に自分でコードを書き、自分で検証し、自分でmainに合流させたものです。起きてからコードレビューしましたが、手直しする箇所は一つもありませんでした」。
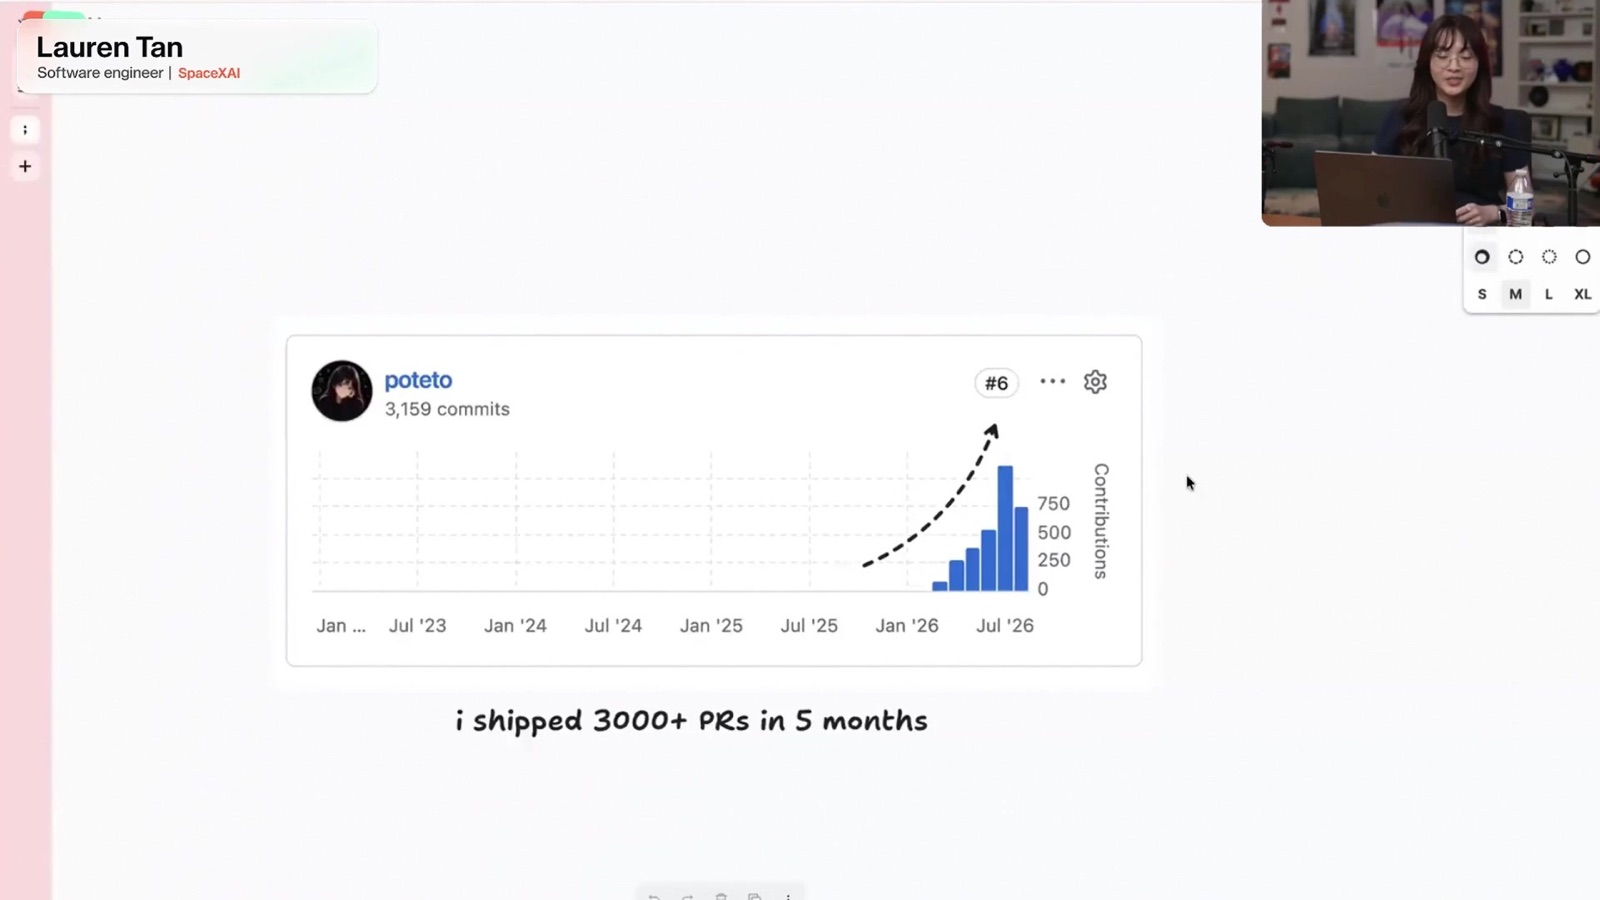
彼女自身、この言葉がいかに危険に聞こえるかをよく理解しています。粗製濫造のスパゲッティコードを垂れ流す人間が大言壮語しているように聞こえかねません。だからこそ、彼女は客観的な数字を提示しました。5か月前にCursorチームに合流した当初、最初の1か月はほぼ目立った成果を出せませんでした。しかし、5か月累計でマージしたPR数は3,000件以上。先月だけで1,000件、今月も12日の時点ですでに800件近くに達しています。彼女は現在SpaceXAIでGrok Botの開発に携わっており、それ以前は長年にわたりMetaでエンジニアを務めていました。
この50分間のセッションでは、小手先のプロンプトテクニックなどは一切語られませんでした。終始一貫して、たった1つの問いに答え続けています。
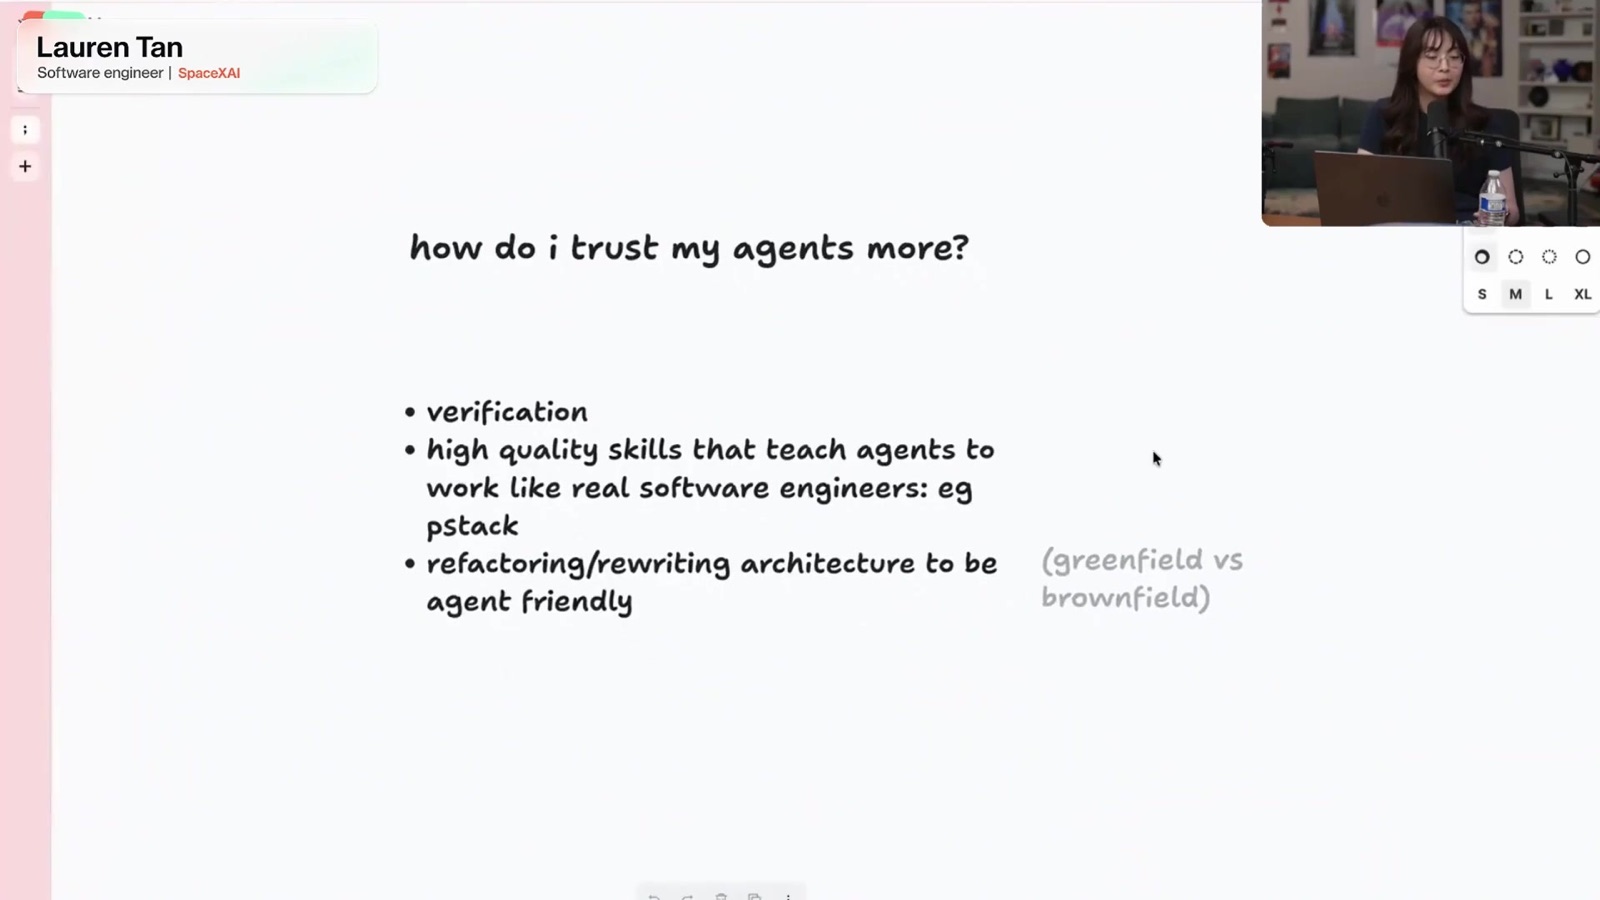
「どうすれば、AIエージェントを心から信頼できるのか?」
以下、彼女の言葉とデモンストレーションをもとに、そのアーキテクチャと方法論を完全に紐解きます。
一、1本の「信頼曲線」から始める
彼女はホワイトボードに1本のグラフを描きました。横軸は「同時に走らせるエージェントの数」(1体、1〜5体、5〜10体、10〜20体、数百体、数千体)。縦軸は「人間側の信頼度」です。
曲線は序盤が急峻で、右肩上がりに伸びていきます。科学的なデータではありませんが、これこそが彼女の5か月間の軌跡そのものでした。
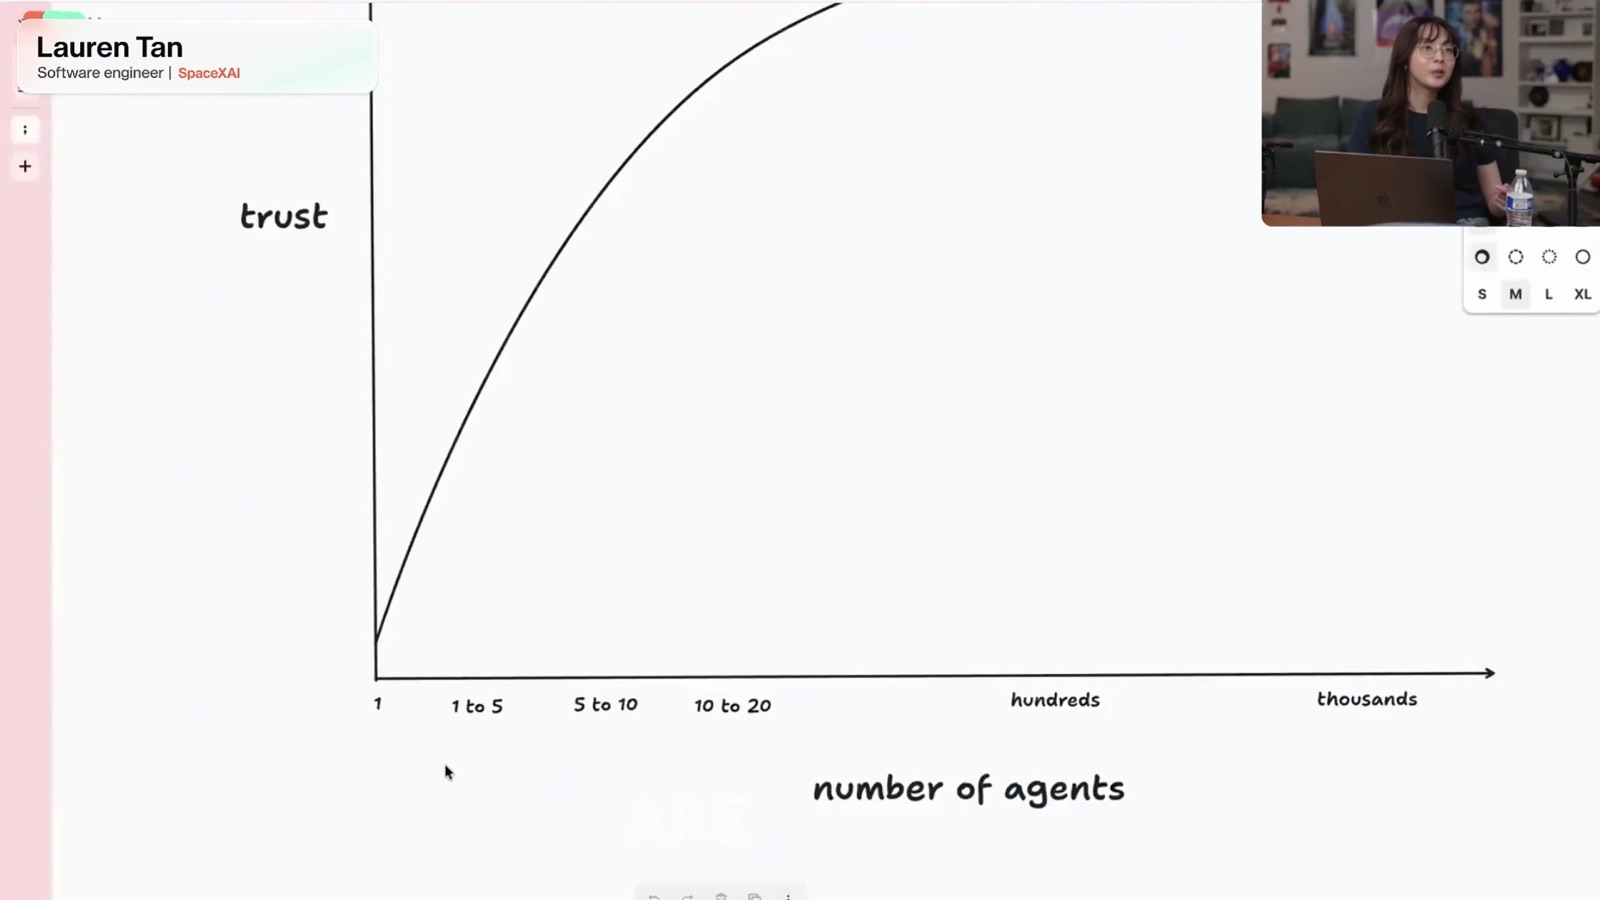
彼女はこれを「エンジニアリングマネジメント」に例えました。もしあなたがエンジニアリングマネージャーで、チームの誰も信用できないとしたら、マイクロマネジメントに走るしかありません。全員の画面を監視し、1行1行コードをチェックし、「誰かが本番環境にバグを押し込むのではないか」と常に怯えることになります。この状態では、どれだけ部下を増やしても意味がありません。あなた自身がチーム全体のボトルネックだからです。
AIエージェントも全く同じです。1〜2体のエージェントを立ち上げ、その出力を息を詰めて見守り、何をしているのか逐一問い詰める——。1体の結果すら信じられない人間が、同時に100体のエージェントを並行稼働させることなど不可能なのです。
二、第1の土台:エージェント自身に「自己検証」させる
エージェントと協働する際、開発者のツールボックスの中で最も重要な能力は「検証(Verification)」です。
ここでの検証とは、エージェントが本物のユーザーとまったく同じように実際にアプリを起動し、操作し、結果を計測できることを意味します。画面を開き、UIをクリックし、スクリーンショットを撮り、CPUトレースを記録し、メモリヒープスナップショットを採取し、iOSシミュレータを立ち上げる。プロダクトがユーザーに提供されているのと同じインターフェースを、エージェント自身がプログラム経由で直接操作できなければなりません。
自己検証は「良いコード」を書くことを保証するわけではありませんが、「動く正しいコード」であることを確実に保証します。これこそが信頼の第1歩です。
彼女はCursor入社初週の体験を振り返ります。リリースを1週間後に控えた「Glass」(Cursorのエージェントウィンドウ機能)のパフォーマンス改善を命じられました。コードベースの構造も分からない中、彼女はChrome DevToolsを開いて手動でCPUプロファイラを回し、フレームグラフとにらめっこしていました。スクリーンショットをエージェントに貼り付けると、エージェントは毎回自信満々に「原因を特定しました!」と答えるものの、修正させてもまったく見当違いの場所でした。
人間が「検証役」を務めている限り、人間がパイプラインのボトルネックであり続けます。エージェントがコードを書き、人間がローカルビルドを実行し、動かないことに気づき、エラーログとスクショをエージェントに再投入する……。このループに囚われている限り、並列作業など夢のまた夢です。
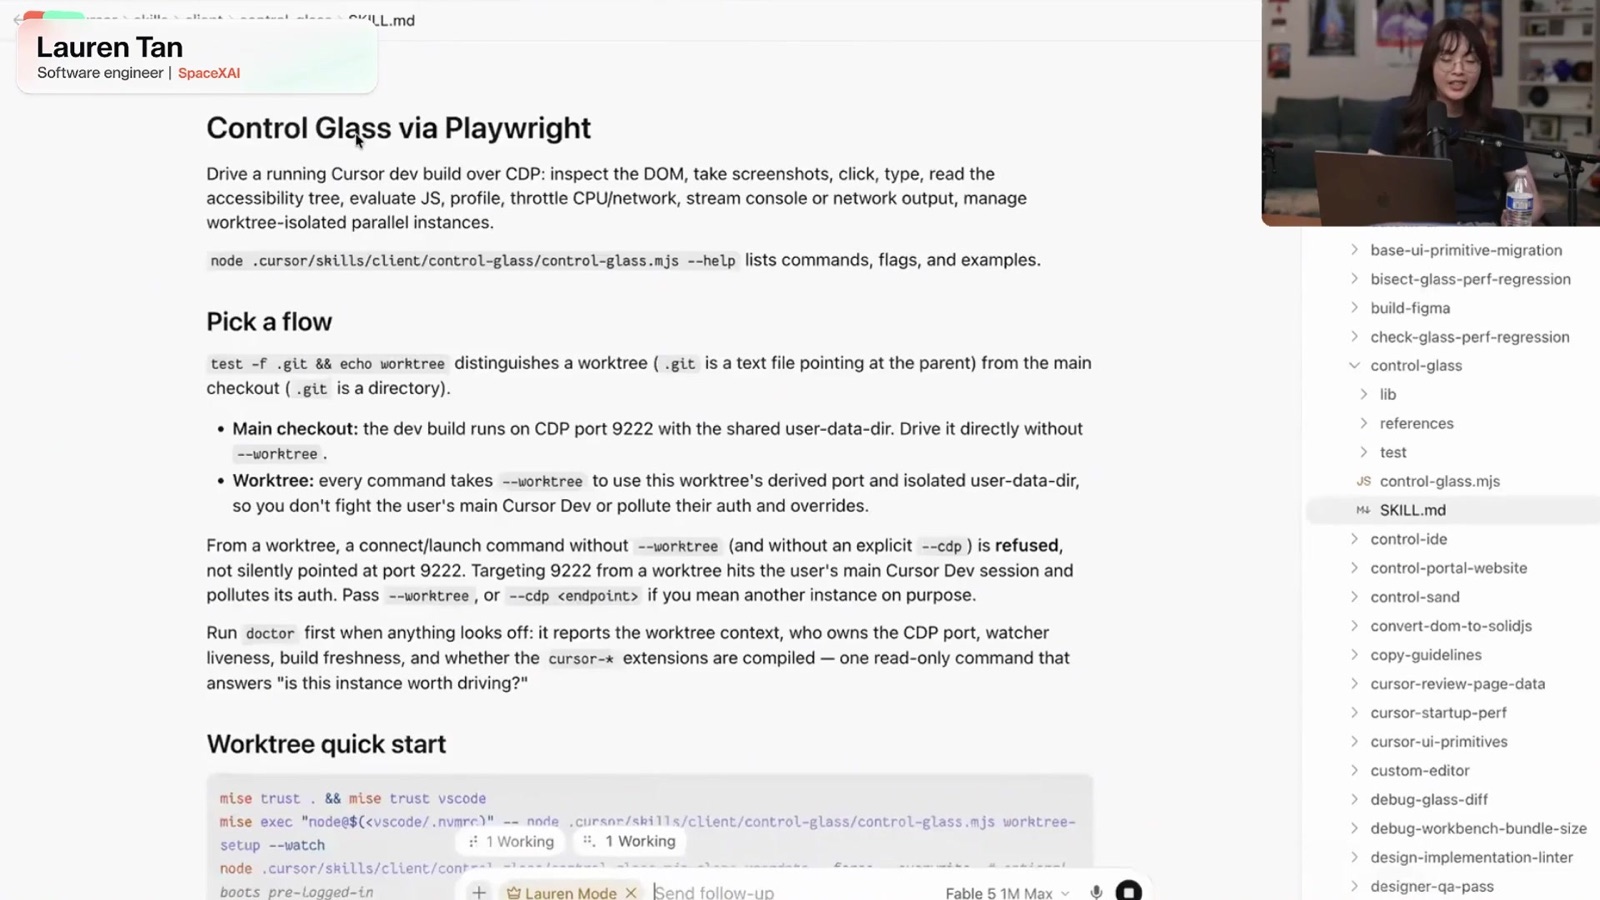
そこで彼女が最初に作ったのが「control glass」というスキルでした。Chrome DevTools Protocol(CDP)を介して、開発ビルド中のCursorをエージェント自身がプログラマブルに操作できるようにしたのです。DOMのインスペクト、スクリーンショット撮影、クリック、キー入力、アクセシビリティツリーの読み取り、JSプロファイラの実行、CPU・ネットワークの帯域制限エミュレーション、コンソールログの監視、そして隔離されたGit worktree内で複数インスタンスを並行起動する機能まで備えていました。
鍵を握る「機能マップ(Feature Map)」
スキルを作ったことで、エージェントはアプリを起動できるようになりました。しかし、次に別の問題が生じました。「アプリの中に何があるのか」をエージェントが知らなかったのです。「左サイドバーが重い」「PRタブの表示が壊れた」といったIssueが来ると、エージェントは巨大なコードベースをあてもなく探索し、該当する機能がどこにあるのか、画面上でどうクリックすればそこに辿り着けるのか分からず迷走しました。
解決策は、スキルに「機能マップ(Feature Map)」を同梱することでした。 機能ごとに1つのMarkdownファイルを用意し、ユーザー視点で完全にドキュメント化します:
- これはどんな機能か
- 画面上でどう操作すればその画面へ行けるのか
- どんなサブ機能やショートカットがあるか
- 要素を特定するための固有DOM属性(
data-testidなど)は何か - 前提条件(開発ビルドが稼働していること、モーダルが開いていないこと等)
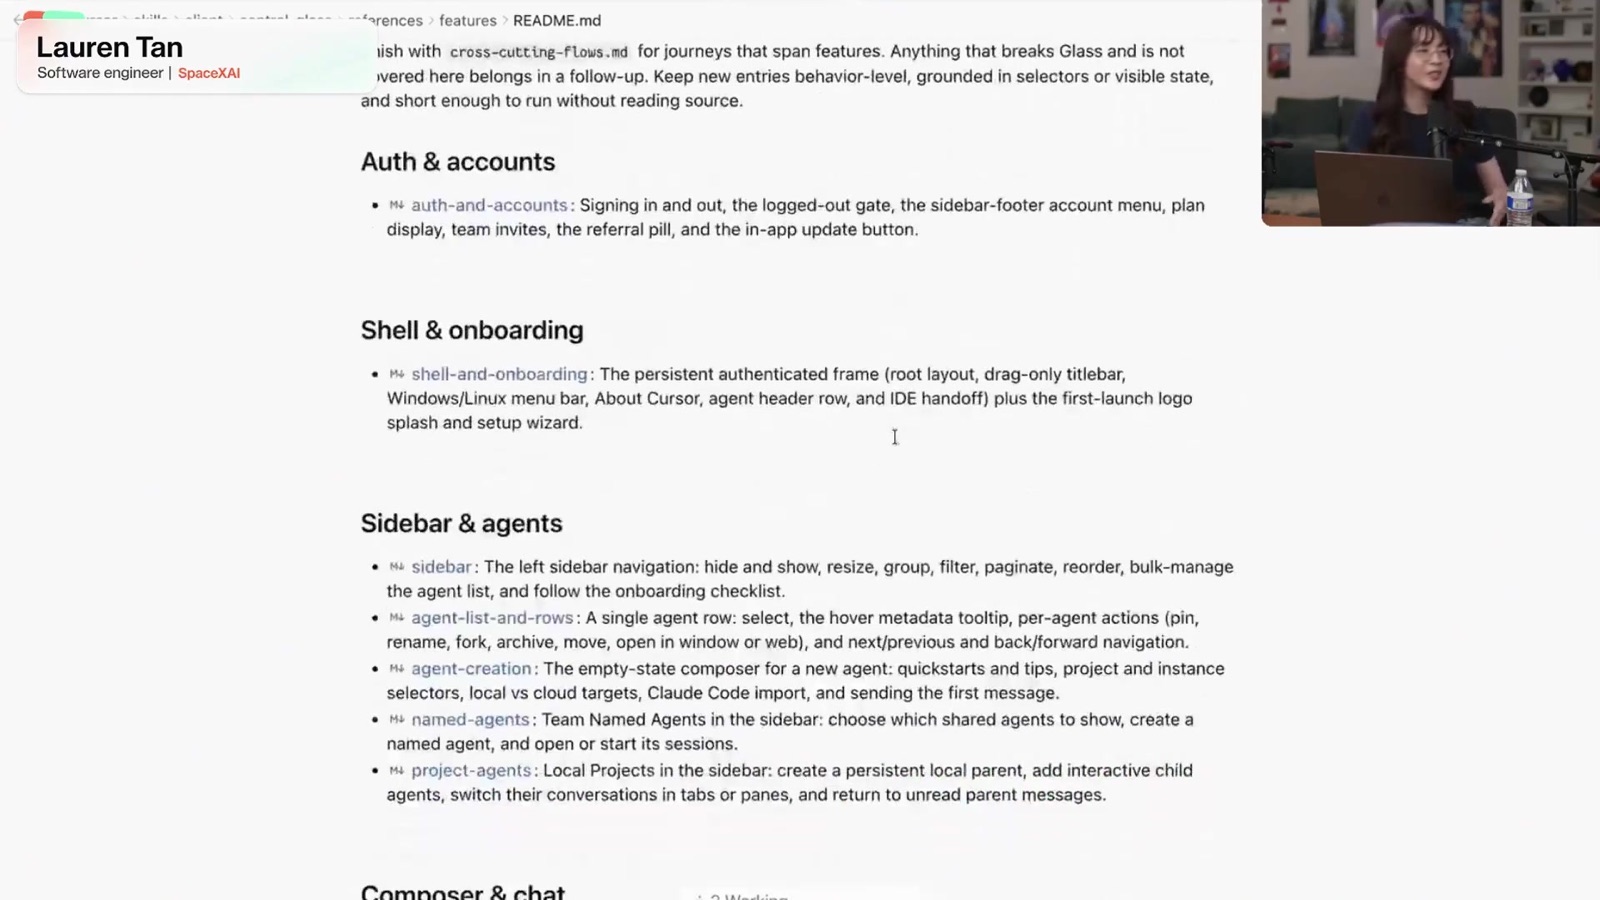
このマップが整備されたことで、質の低いバグ報告でも自律解決できるようになりました。社内Slackに「???」というテキストと共に画面スクショだけが放り込まれても、エージェントは機能マップと照合して該当画面を特定し、自らUIを操作してバグを再現させることができるようになったのです。
彼女はこの仕組みをオープンソースの「pstack」プラグインとして体系化しました。コードベースを自動探索して初期の機能マップを生成するスキルや、日々のアップデートに合わせてマップを自動メンテナンスするスキルが同梱されています。
三、第2の土台:失敗パターンを観測し「Skills」として形式知化する
Laurenが作成した「pstack」という名前は、YCのCEO Garry Tanが作った「gstack」にちなんだジョークですが、中身は彼女自身の泥臭いエンジニアリングの結晶です。
彼女は最初から壮大なプラグインを作ろうとしたわけではありません。エージェントがやらかした「失敗パターン」を観測するたびに、それを防ぐスキルを1つずつ書き足していった結果、自然と成長したものです。
初期の頃、エージェントが「原因は間違いなくここです!」と確信めいて報告してきた際、ツール呼び出しログを確認すると、関連コードを1行も読んでいないことがありました。彼女の信頼度は一瞬でゼロに落ちました。
しかし、彼女は落胆する代わりにこう考えました。「5秒前に入社したばかりの、コードは書けるが業務コンテキストを全く持たない新人エンジニアがいたら、どう育てるか? 自分の経験とノウハウを丁寧に言語化して教えるはずだ」と。
LLMにとっての「教育」こそがスキル(Skills)です。スキルとは本質的にはMarkdownファイルですが、人間の長年のエンジニアリング知見を大量に注入できます。言語モデルは次のトークンを予測するシステムです。高品質なコンテキストとベストプラクティスをあらかじめ注入しておけば、モデルは自ずと賢明な推論経路を選択するようになります。
彼女の流儀は極めて実直です。「エージェントが失敗するたびに、その失敗を二度と起こさせないスキルを書く」。「勝手に推測するな、まずコードを読め」「サブエージェントを活用しろ」「あてずっぽうの修正をやめろ」といった泥臭い指示がスキルとして蓄積されていきました。
エージェントの失敗を発見するため、彼女は「最高のペアプログラミング相手」として振る舞いました。エージェントのツール呼び出しログをこまめに展開し、思考プロセス(Thinking Process)を丹念に読み込み、どこで道を踏み外したのかを特定してスキルへと昇華させたのです。
四、第3の土台:クラウドへ解き放ち、並列で走らせる
ローカル環境で「自己検証」と「スキル」が機能し始めると、自然と次の欲求が生まれます。「なぜ自分のMacBook上で1〜2体しか動かしていないのか? クラウドに投げて同時に20体走らせればいいのではないか?」と。
彼女はCursorのバックグラウンドタスク(Background Agents)を活用し、タスクを投げては放置し、別の作業に移るワークフローへと移行しました。朝起きると数十件のPRがmainブランチに自動マージされている状態は、こうして実現されたのです。
五、Duneアーキテクチャ:厳格な境界でエージェントを縛る
Grok Botの大規模リファクタリングにおいて、彼女は「Dune」と名付けた厳格なアーキテクチャを導入しました。
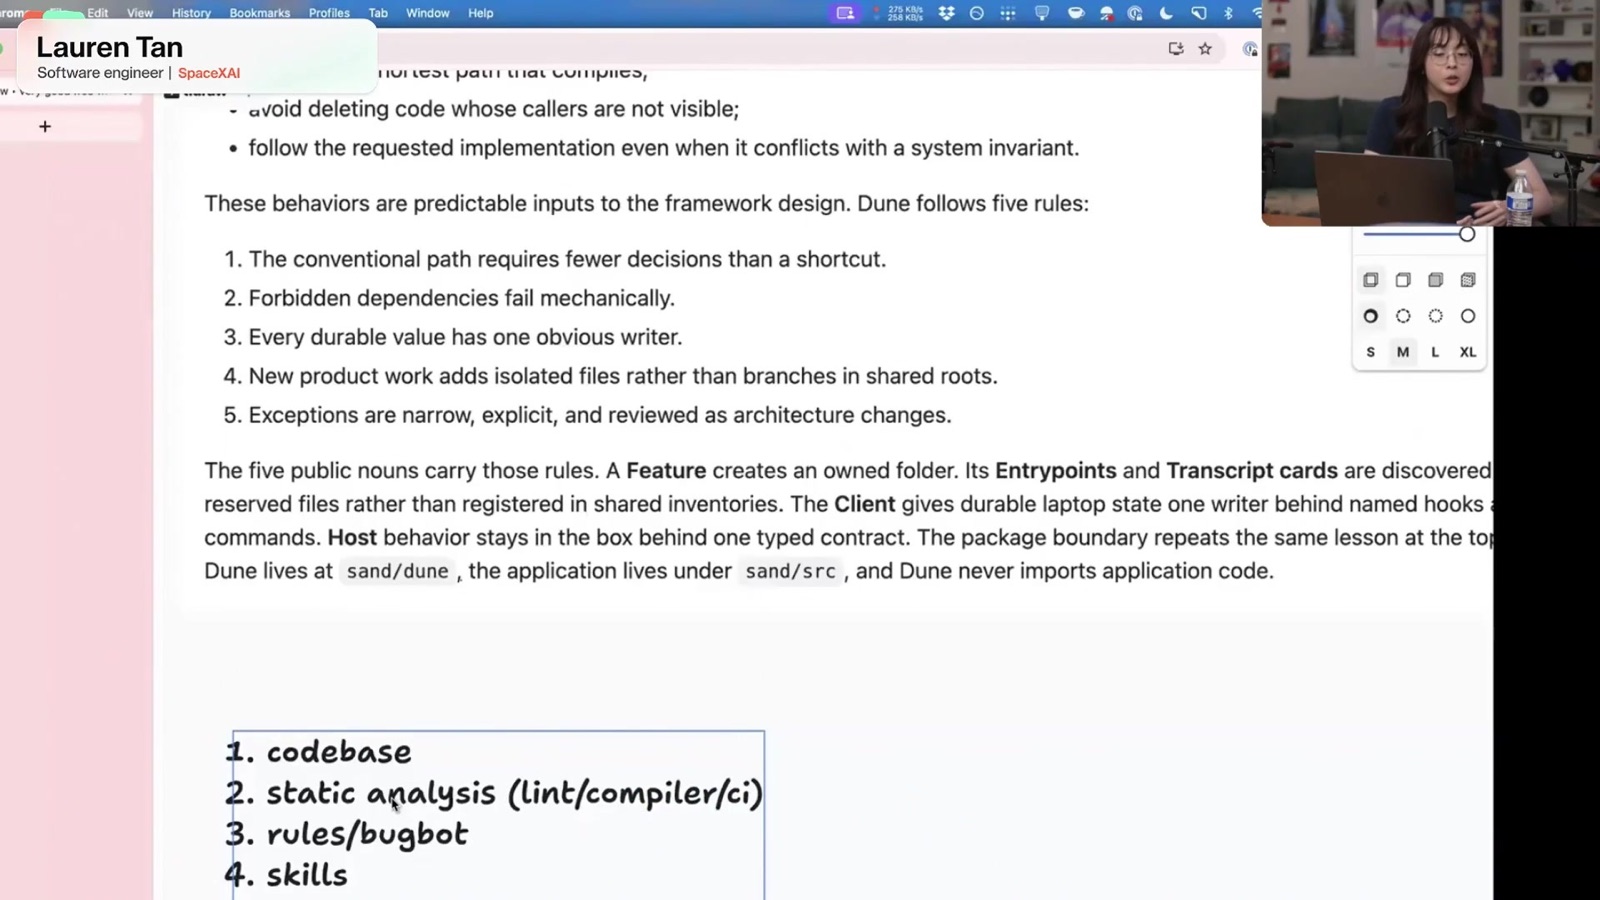
Duneの設計思想は極めてシンプルです。
- すべてがステートマシンであること
- すべての副作用(ネットワーク、ファイルI/Oなど)は末端の純粋なエッジに追いやること
- ビジネスロジックは100%純粋関数(Pure Functions)で構成し、極限までテストを自動化すること
- モジュール間の境界(Boundary)を厳格に定義し、越境をコンパイラレベルで禁じること
エージェントに「自由にコードを書いていい」と野放しにすると、アーキテクチャは数日で崩壊します。しかし、Duneのように「この箱の中の純粋関数だけを書き換えろ」「副作用のインターフェースには手を触れるな」という強固な制約があれば、エージェントは迷う余地がありません。作業の8割が狭いスコープ内で完結するため、ハルシネーションの余地が物理的に遮断されるのです。
六、5層の制約システム:本当に機能するのは「最初の2層」だけ
彼女は、健全なコードベースを維持するための制約を5つのレイヤーに分類しています。
- コードベース自体のアーキテクチャ構造と不変の規約
- 静的解析:Linter、コンパイラ、厳格なCIパイプライン
- ルール定義ファイル(AGENTS.mdなど)と自動コードレビューボット
- Skills(Markdownによる指示書)
- 人間のスタイルガイド・ドキュメント
最初の2層は「ハードな制約」です。 違反すればビルドが落ち、CIが赤く光り、マージが機械的に弾かれます。一方、後ろの3層は「ソフトな制約」に過ぎません。 エージェントは平気で指示を忘れ、文脈によってブレます。
彼女は率直に言い放ちました。「もしあなたのリポジトリが、ルールファイルやスキル、人間のコードレビューといったソフトな制約だけに頼っているなら、そのコードベースが粗大ゴミの山に化けるのは時間の問題です」。
RustがAI時代に再評価されている理由もここにあります。コンパイラが異常なほど厳格だからです。unsafeブロックを禁止し、型チェックとライフタイムを通過したコードであれば、人間が1行ずつレビューしなくても高確率で安全に動作します。
「コードレビューで人間が『ここはこう書かないでください』とコメントを打っている状態は、設計の敗北(Code Smell)です。レビューで指摘したくなった瞬間、自問してください。『これをESLintのルールに落とし込めないか?』『CIの失敗として機械的に検知できないか?』『アーキテクチャ上、そもそもそのバグが記述不可能な構造にできないか?』と」。
また、彼女はPRの粒度を極めて小さく保つことを徹底させています(1つのPRにつき50〜300行程度)。1つのPRで1つの関心事だけを解決させ、何かあれば即座にリバートできるようにするためです。
七、トークン代の費用対効果(ROI)
「ラボ勤務だから無制限にトークンを使えるだけで、一般企業には非現実的では?」という会場からの質問に対し、彼女は費用対効果(ROI)の視点から反論しました。
「確かに初期段階では膨大なトークンを消費します。リファクタリング、制約の追加、スキルの整備にはコストがかかります。ですが、もうひとつの選択肢は何でしょうか? 人間のシニアエンジニアを採用することです。もしエージェントを使わずに私ひとりでこれらすべてのリファクタリング、テスト、検証基盤を構築していたら、何年もかかっていたはずですし、私の人件費は決して安くありません」。
一度強固な制約と検証基盤さえ整ってしまえば、Claude 3.5 SonnetやGemini Flashのような軽量・安価なモデルでも極めて高品質なコードを量産できるようになります。細かいトークン代をケチるよりも、人間組織のスケール限界を突破することのほうが遥かに巨大なリターンを生むのです。
八、エンジニア以外もコードを修正できる世界へ
このアーキテクチャがもたらした最大の恩恵は、非エンジニアのメンバーが直接リポジトリにコミットできるようになったことです。
Grok Botのチームでは、プロダクトマネージャー(PM)やデザイナー、GTM(営業・マーケティング)の担当者が、エージェントを使って自分でバグを修正しPRを出してきます。「ここ直しておいたので確認してください」とPMからPRが届き、彼女が確認すると完璧にテストが通っており、そのまま1クリックでマージされる。厳格な制約(ガードレール)があるからこそ、コードの専門知識がない人でも安全に最高品質の成果物をコミットできるのです。
明日から実践できる4つのステップ
- プロダクトの検証スキルを作る: エージェント自身がアプリを起動し、操作し、スクショを撮り、エラーログを自ら回収できるようにする。
- 機能マップを整備する: ユーザー視点から各画面・各機能への到達方法をMarkdownで1機能1ファイルで記述する。
- エージェントを注意するたびにスキル化する: 口頭で叱るのをやめ、失敗パターンをスキルに昇華させ、evalで回す。
- レビューの指摘事項をCIとLintに昇華させる: 人間が指摘したルールは、即座にコンパイラや静的解析のハードな制約へ落とし込む。
モデルは数か月ごとに最新型へと入れ替わります。しかし、あなたがコードベースに敷き詰めた「自己検証」「スキル」「制約システム」は、将来どんな超知能モデルが登場しようとも、そのまま色褪せない最強の資産として機能し続けます。
あなたは今、何体のエージェントを同時に走らせていますか? そして、あの信頼曲線のどの地点に立っているでしょうか?