목차
- SpaceXAI 소프트웨어 엔지니어, Lauren Tan
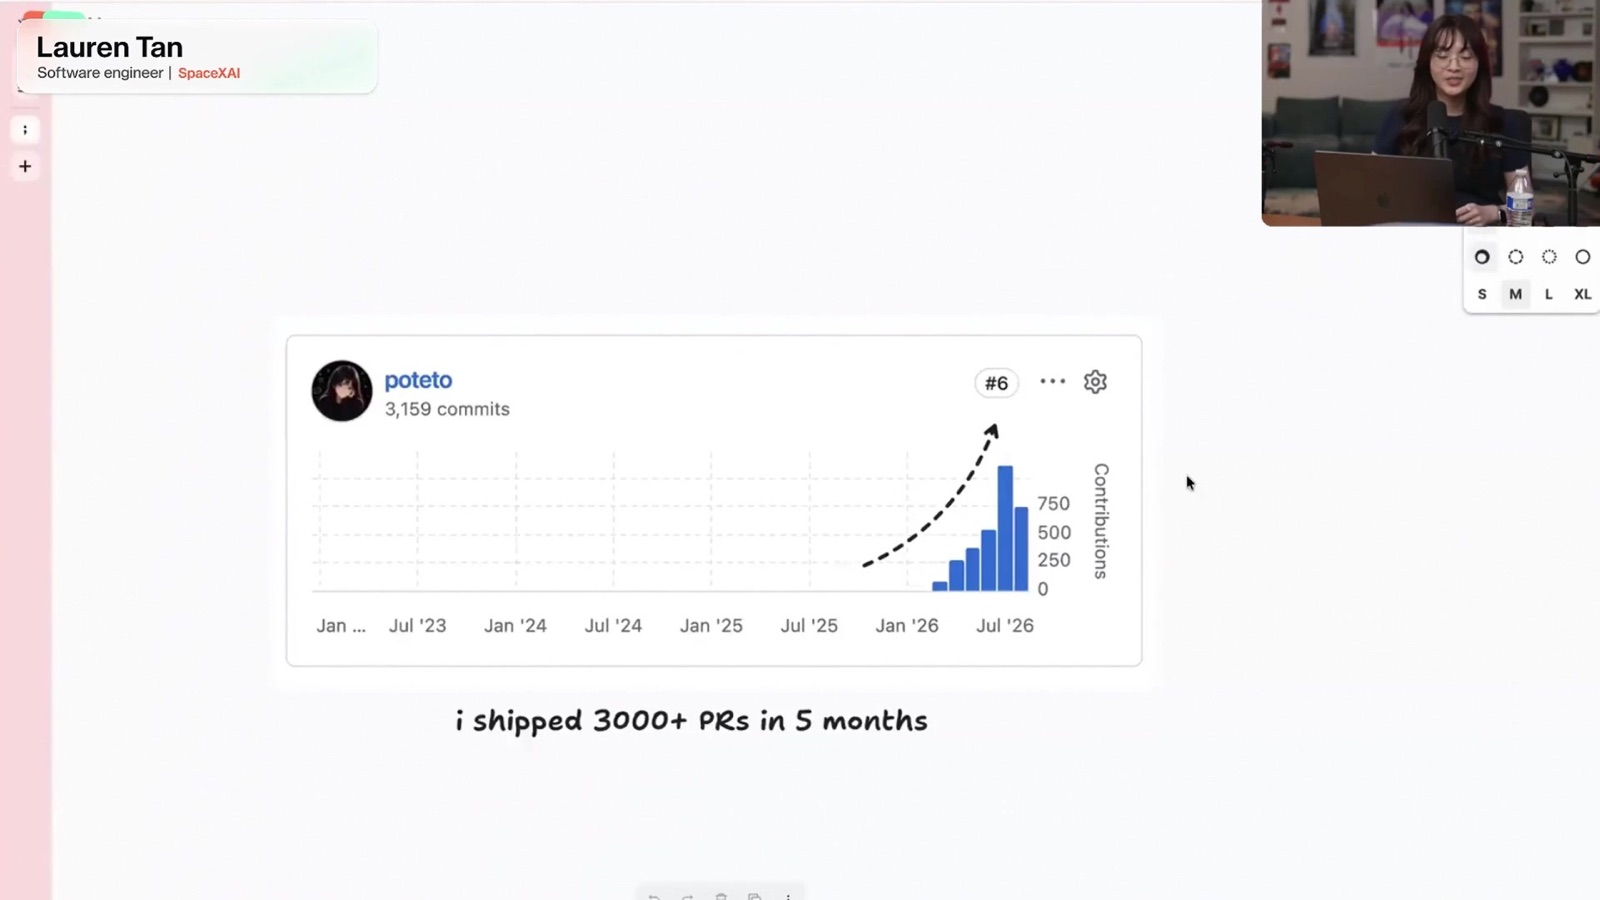
- 그녀의 GitHub 컨트리뷰션 그래프: 5개월간 3,000개 이상의 PR
- 1. 먼저 신뢰 곡선을 이해해야 합니다
- 그녀가 직접 그린 신뢰 곡선: 가로축은 동시 실행 에이전트 수
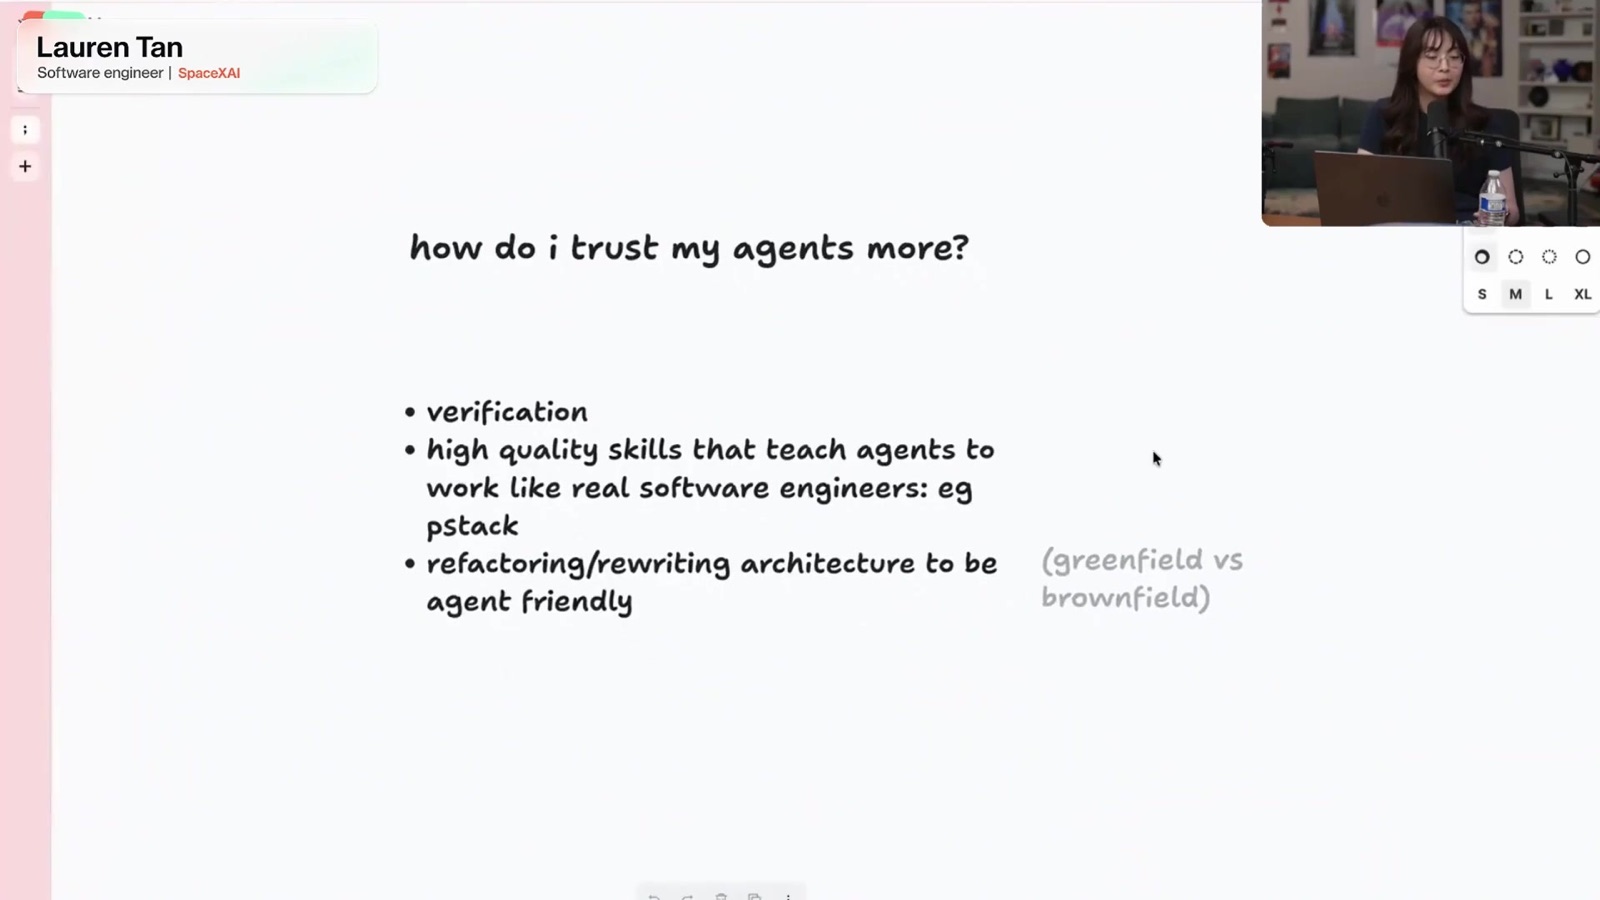
- 에이전트 신뢰 구축의 3요소: 검증, 고품질 스킬, 친화적 아키텍처
- 2. 첫 번째 기반: 에이전트 스스로 검증하게 만들기
- 3. 기능 지도(Feature Map): 에이전트에게 길을 알려주기
- 4. 두 번째 기반: 에이전트가 진짜로 따르는 스킬 만들기
- 5. 세 번째 기반: 에이전트 친화적인 아키텍처 (Dune)
- 6. 제약의 5단계 레이어
- Dune 아키텍처의 5가지 룰과 수기 작성된 제약 레이어
- PR은 철저히 작게 쪼개기
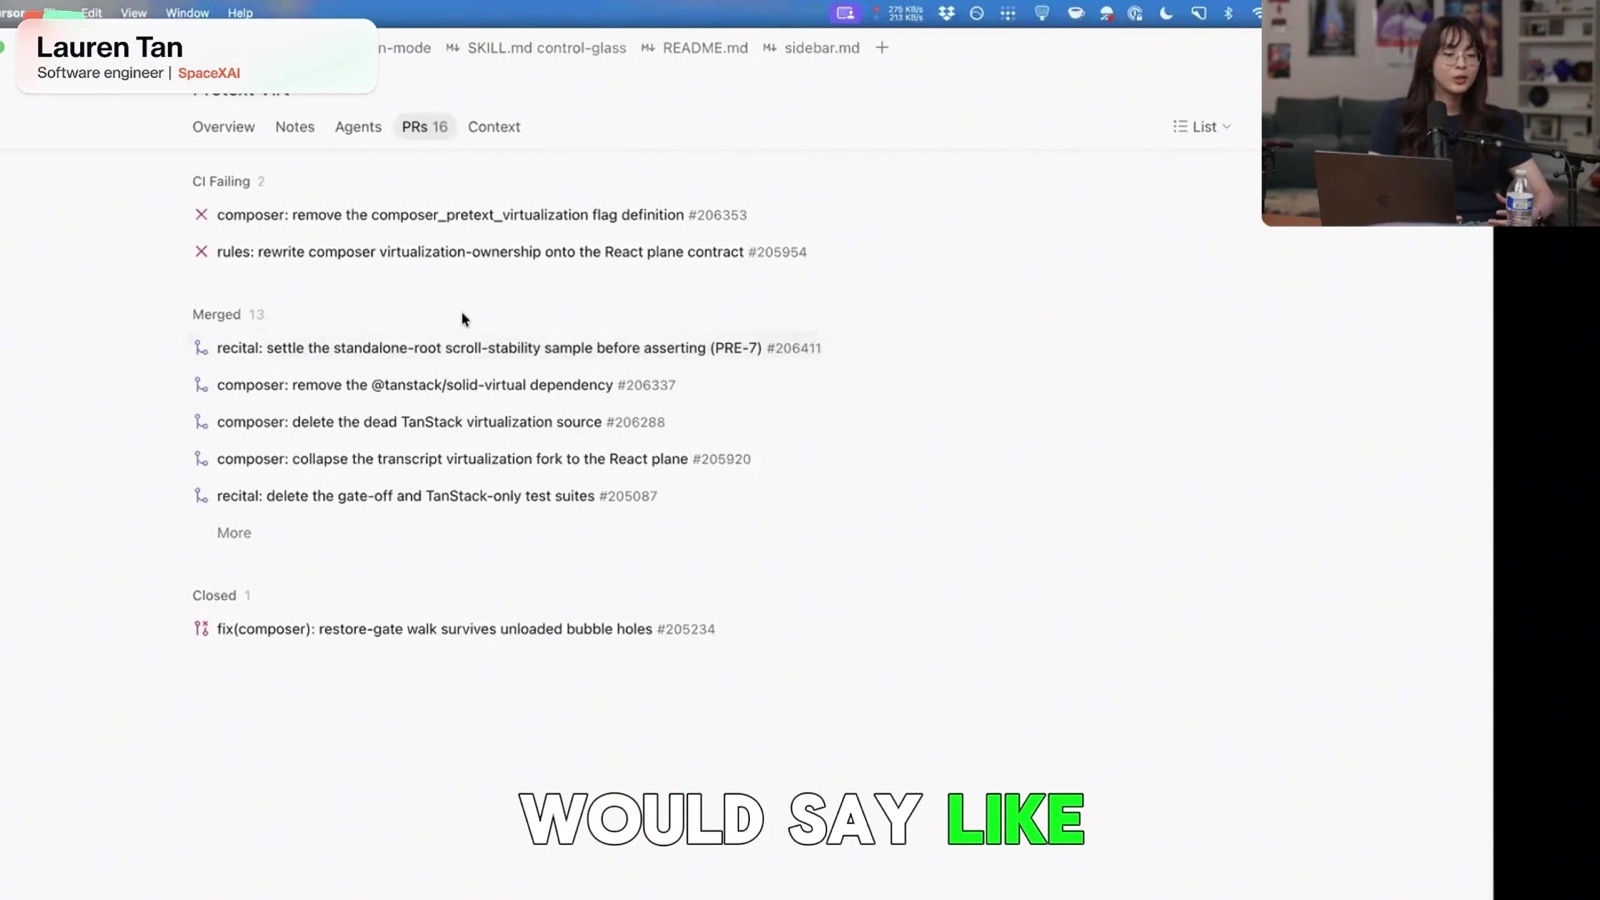
- 그녀가 시연한 PR 목록: CI 실패, 머지 완료, 클로즈 내역
- 7. 토큰 비용, 과연 남는 장사인가?
- 8. 비개발자도 기여하는 팀의 미래
- 내일부터 당장 적용할 수 있는 4단계
자신의 방법론을 아낌없이 공개해 준 Lauren Tan에게 먼저 감사를 전합니다. 5개월 동안 겪은 수많은 삽질, 직접 구현한 스킬들, Grok Bot을 리팩토링하며 쏟아부은 600여 개의 PR까지, 50분의 발표 동안 모든 노하우를 솔직하게 털어놓았습니다. 평가(eval) 시 에이전트가 자신이 테스트받고 있음을 눈치채지 못하게 하는 극세사 팁까지 전부 담겨 있어 정말 귀중한 인사이트였습니다.
풀 영상을 X에 공유해 준 @akarixbt 님 덕분에 접할 수 있었는데, 정말 버릴 내용이 하나도 없는 알짜배기였습니다.
Lauren Tan은 세션 중 이런 말을 했습니다: “오늘 아침 눈을 떴을 때, 메인 브랜치에 이미 20개의 새로운 PR이 머지되어 있었습니다.” 밤사이 그녀의 에이전트들이 스스로 코드를 작성하고, 테스트를 돌리고, 검증까지 끝내 메인에 합쳐둔 것이죠. 그녀는 기상 후 main 브랜치에서 가볍게 리뷰를 진행했을 뿐인데 딱히 흠잡을 구석이 없었다고 합니다.
SpaceXAI 소프트웨어 엔지니어, Lauren Tan
그녀 역시 이런 말이 겉으로는 저품질 코드를 마구 양산하는 사람의 허세처럼 들릴 수 있다는 것을 잘 알고 있었습니다. 그래서 즉시 실제 지표를 공개했습니다: 5개월 전 Cursor에 합류했을 당시 첫 달에는 산출물이 거의 없었지만, 5개월 동안 총 3,000개가 넘는 PR을 머지했습니다. 지난달에만 1,000개, 이번 달은 12일 만에 이미 800개에 육박했습니다. 그녀는 현재 SpaceXAI에서 Grok Bot을 개발하고 있으며, 이전에는 Meta에서 수년간 근무한 베테랑 엔지니어입니다.
그녀의 GitHub 컨트리뷰션 그래프: 5개월간 3,000개 이상의 PR
50분이 넘는 이번 세션에서 그녀는 현란한 프롬프트 작성 꼼수를 말하지 않았습니다. 처음부터 끝까지 단 하나의 본질적인 질문만을 파고들었습니다: “어떻게 해야 내 AI 에이전트를 진정으로 신뢰할 수 있는가?”
그녀의 실제 발표와 시연 내용을 바탕으로 핵심 방법론을 정리해 드립니다.
1. 먼저 신뢰 곡선을 이해해야 합니다
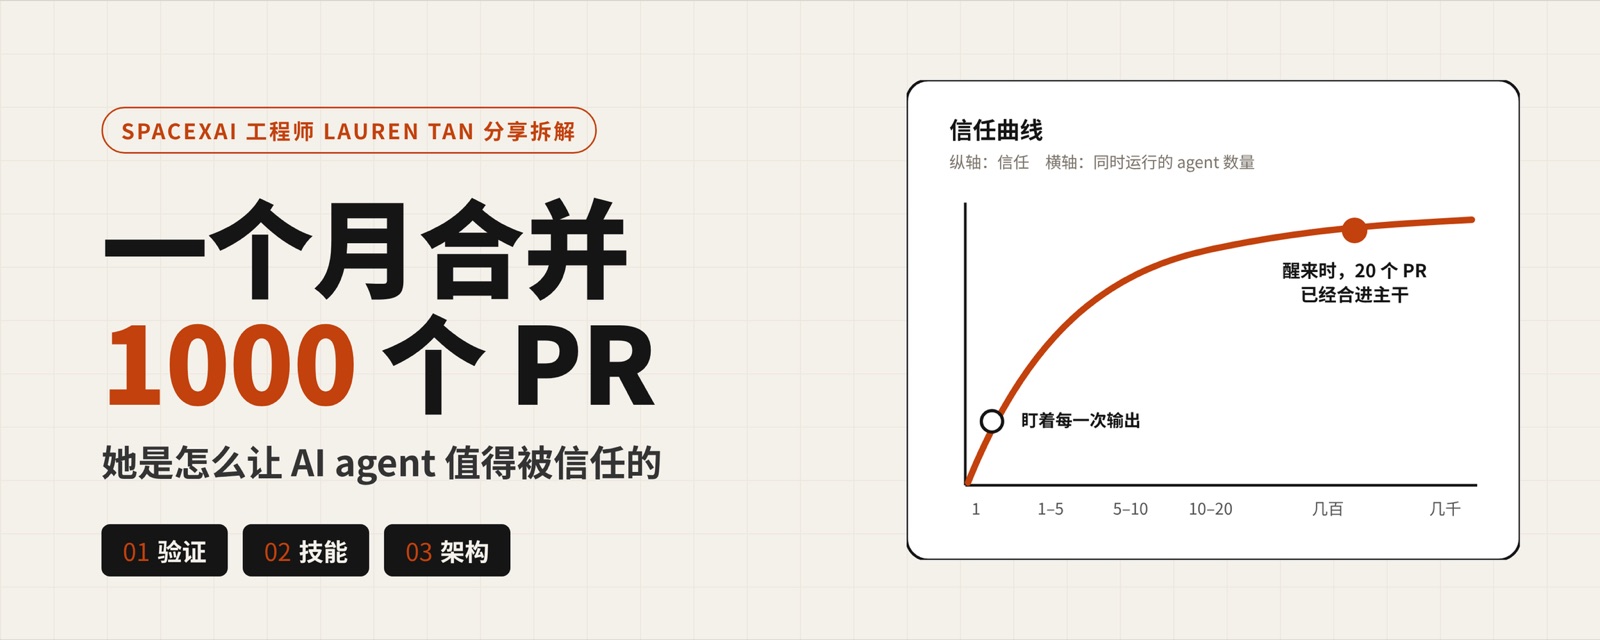
그녀는 화이트보드에 그래프 하나를 그렸습니다. 가로축은 동시에 구동되는 에이전트의 수(1개, 15개, 510개, 10~20개, 수백 개, 수천 개), 세로축은 ’신뢰(Trust)’입니다.
곡선은 초반에 가파르게 상승하다가 완만해집니다. 과학적인 수치는 아니지만, 지난 5개월간 그녀가 직접 겪은 현실의 여정 그 자체였습니다.
그녀가 직접 그린 신뢰 곡선: 가로축은 동시 실행 에이전트 수
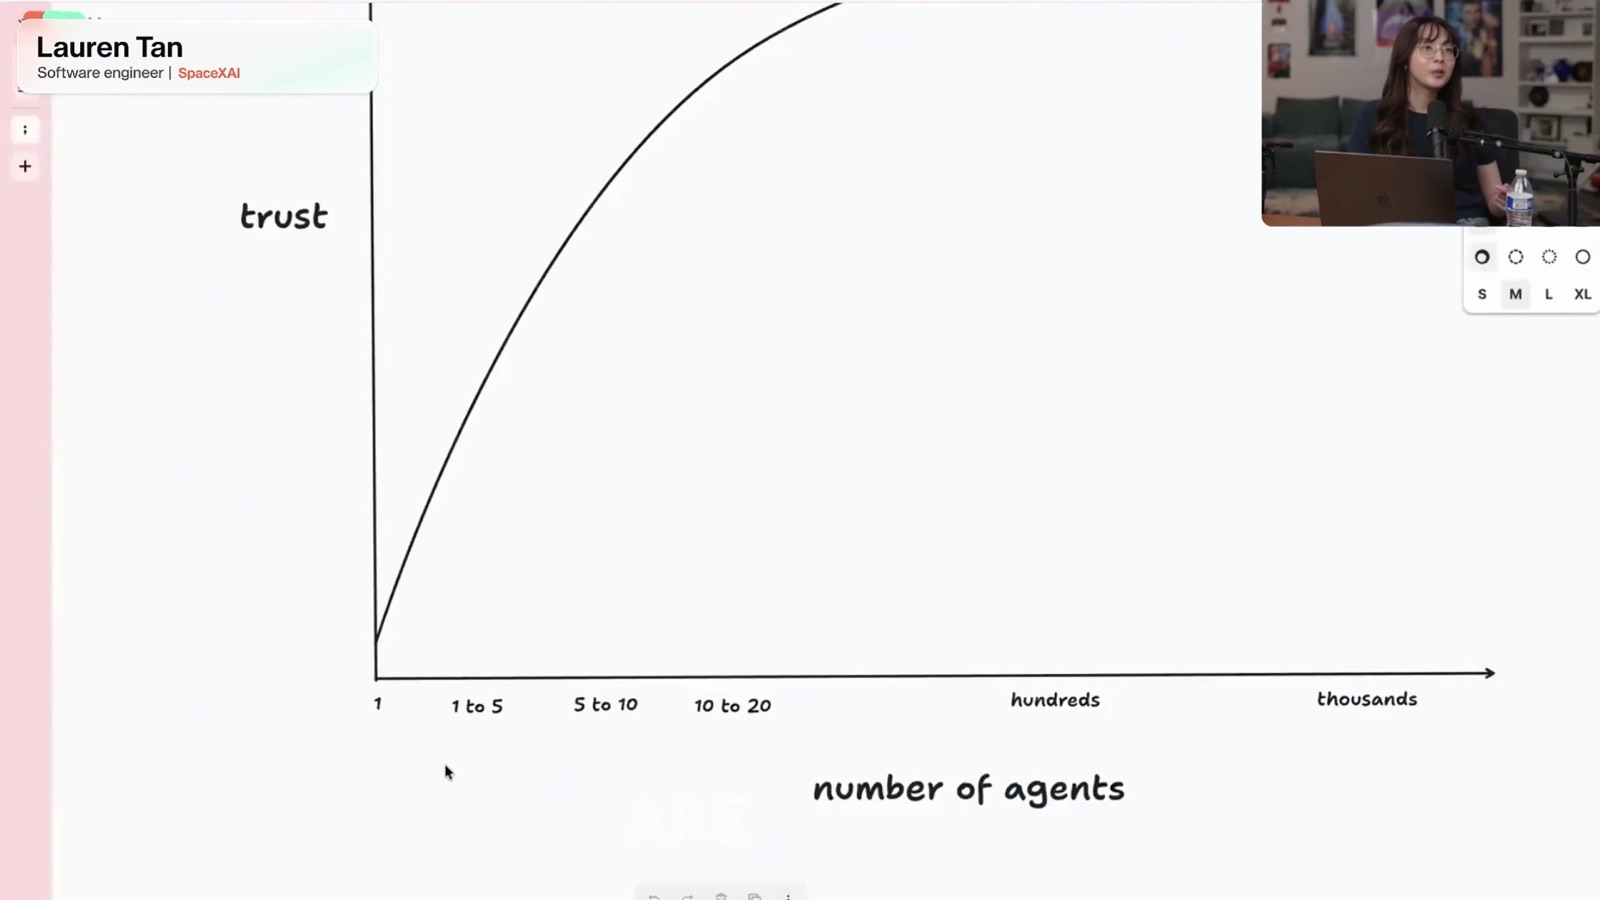
그녀는 이를 조직 관리에 빗대어 설명했습니다. 엔지니어링 매니저가 팀원을 단 한 명도 신뢰하지 못한다면 마이크로매니지먼트에 빠질 수밖에 없습니다. 모니터를 훔쳐보고, 코드 한 줄 한 줄을 일일이 검사하며, 누군가 프로덕션에 버그를 배포할까 봐 전전긍긍하죠. 이런 상태에서는 팀 규모가 아무리 커져도 매니저 본인이 병목이 되기 때문에 조직 전체가 마비됩니다.
에이전트를 다룰 때도 똑같습니다. 1년 전 대부분의 개발자들은 에이전트를 한두 개 띄워두고, 매 답변마다 모니터를 뚫어져라 쳐다보며 “지금 뭐 하고 있니?“를 끊임없이 캐물었습니다. 단 하나의 에이전트가 내놓은 결과조차 신뢰하지 못하는 상태에서는 동시에 100개의 에이전트를 굴리는 건 불가능합니다.
단 하나의 에이전트도 믿지 못하면서 100개의 에이전트를 동시에 굴릴 수는 없습니다.
그녀가 제시한 신뢰 구축의 3대 기둥은 검증 역량(Verification), 고품질 스킬(High-Quality Skills), 에이전트 친화적 아키텍처(Agent-Friendly Architecture)입니다.
에이전트 신뢰 구축의 3요소: 검증, 고품질 스킬, 친화적 아키텍처
2. 첫 번째 기반: 에이전트 스스로 검증하게 만들기
그녀는 에이전트 협업에서 도구함에 갖춰야 할 가장 중요한 능력으로 ’검증(Verification)’을 꼽았습니다.
여기서 검증이란 에이전트가 실제 사용자처럼 프로그램을 직접 실행하는 능력을 의미합니다: 앱을 띄우고, 마우스로 클릭하고, 화면을 캡처하고, CPU 트레이스를 수집하고, 메모리 스냅샷을 찍고, iOS 시뮬레이터를 조작하는 것입니다. 사용자에게 제품이 노출되는 바로 그 방식으로 에이전트도 작동하고 확인해야 합니다.
검증이 에이전트의 뛰어난 코딩 실력을 100% 보장하지는 못하지만, 적어도 ’작동하는 올바른 코드’를 작성하도록 강제합니다. 이것이 신뢰의 출발점입니다.
그녀는 입사 첫 주의 경험을 들려주었습니다. 당시 Cursor의 에이전트 윈도우(내부 코드명 Glass) 성능 최적화 태스크에 긴급 투입되었는데 일주일 뒤가 바로 런칭이었습니다. 코드베이스를 전혀 모르는 상태에서 Chrome DevTools를 열고 트레이스를 뜨며 불꽃 그래프(Flame chart)를 들여다보았죠. 스크린샷을 에이전트에게 보내면 에이전트는 근본 원인을 찾았다고 매번 자신만만하게 말했지만, 막상 코드를 고쳐보면 전혀 엉뚱한 곳이었습니다.
그 상태에서는 사람(개발자)이 검증자 역할을 하느라 전체 파이프라인의 극심한 병목이 됩니다. 에이전트가 코드를 짜면 사람이 로컬 빌드를 돌리고, 에러가 나면 캡처와 콘솔 로그를 복사해 다시 먹여주는 쳇바퀴에 갇혀 병렬 처리가 불가능해집니다.
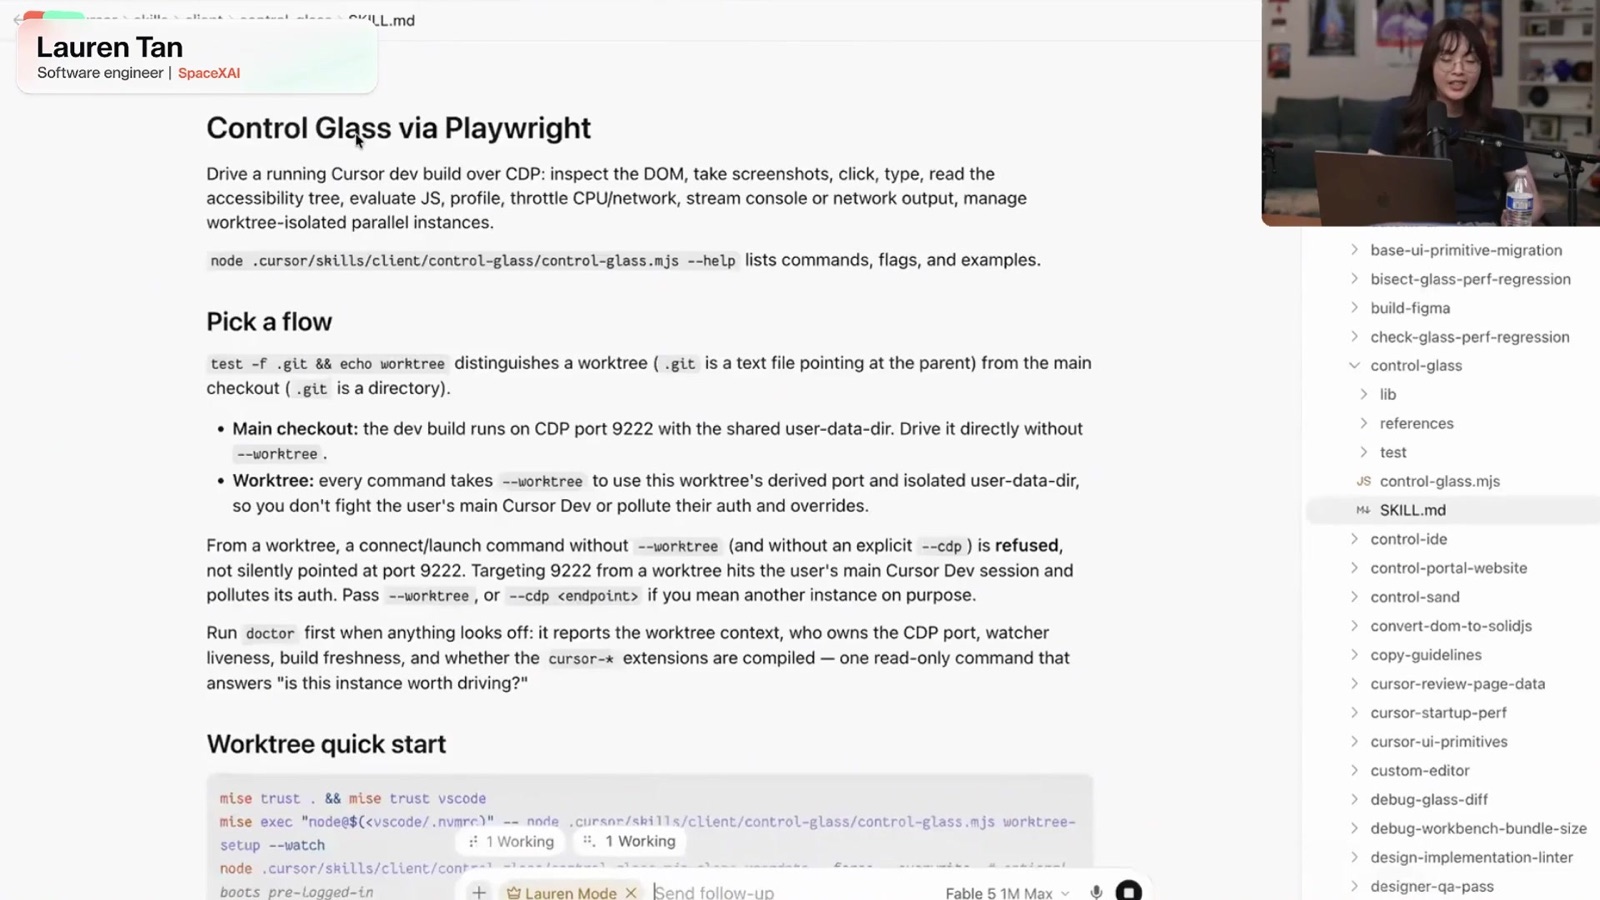
그래서 그녀가 만든 첫 번째 스킬이 바로 control glass였습니다. 에이전트에게 Chrome DevTools Protocol을 통해 개발 버전의 Cursor를 직접 제어하는 법을 가르쳤습니다: DOM을 검사하고, 캡처를 뜨고, 클릭하고, 텍스트를 입력하고, 접근성 트리를 읽고, JS 프로파일을 돌리고, CPU 및 네트워크 쓰로틀링을 시뮬레이션하고, 콘솔 에러를 읽게 만들었습니다.
이제 에이전트는 코드를 수정한 뒤 스스로 앱을 띄우고, 작업을 수행하고, 화면을 캡처해 비교합니다. 이 스킬이 완성된 뒤 그녀는 2주 만에 50개의 성능 최적화 PR을 머지할 수 있었습니다.
에이전트가 자신의 손발로 직접 검증할 수 있어야 비로소 개발자는 모니터 앞을 떠나 커피를 마시러 갈 수 있습니다.
3. 기능 지도(Feature Map): 에이전트에게 길을 알려주기
UI를 검증하려면 에이전트가 특정 화면으로 이동할 줄 알아야 합니다.
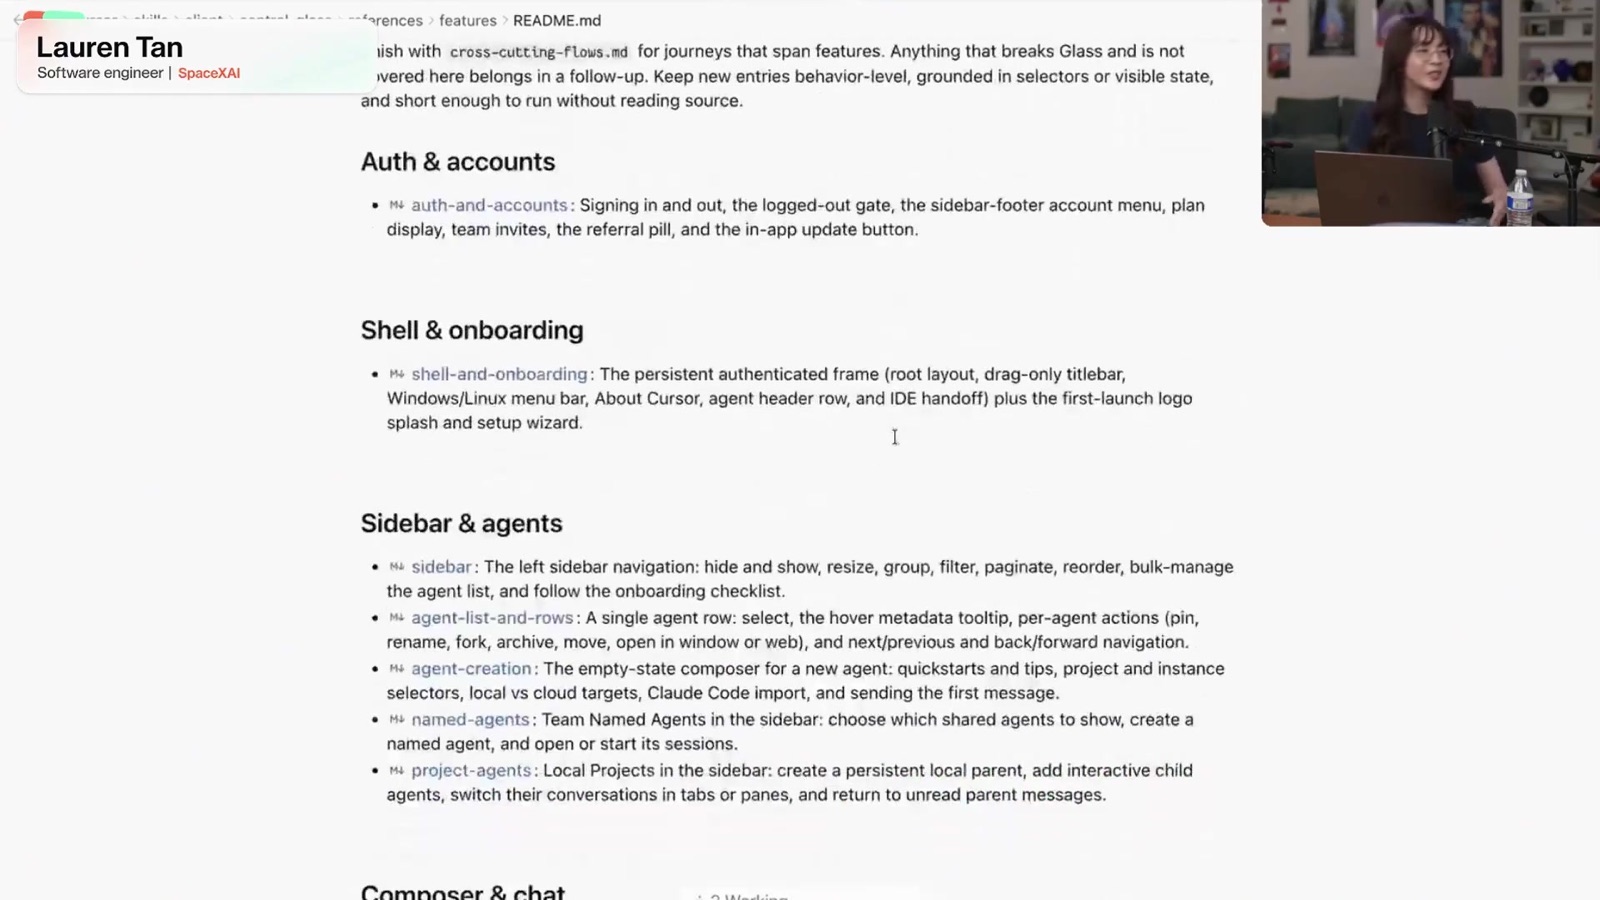
하지만 전체 설정 화면을 둘러보고 오라고 하면 에이전트는 무작위로 클릭하다가 헤매기 일쑤입니다. 그래서 그녀는 기능 지도(Feature Map) 체계를 구축했습니다.
코드베이스 내부에 각 기능별로 마크다운 파일을 하나씩 만들었습니다: 파일 탐색기, 확장 프로그램, 터미널, 깃 패널 등. 각 파일에는 해당 기능으로 진입하기 위한 단축키, 셀렉터, 기대 상태를 명확히 적었습니다.
에이전트는 검증을 시작하기 전 기능 지도를 먼저 읽고, 명시된 경로를 따라 정확히 화면을 찾아가 검증을 수행합니다.
4. 두 번째 기반: 에이전트가 진짜로 따르는 스킬 만들기
많은 사람들이 겪는 고통: “에이전트에게 규칙을 알려줬는데 자꾸 까먹고 무시해요.”
그녀는 이를 스킬의 설계 결함으로 보았습니다. 텍스트 프롬프트 몇 줄 적어둔 것은 스킬이 아닙니다. 그녀가 제시한 진짜 고품질 스킬의 조건:
- 문제의 배경과 원인을 설명할 것: 단순한 규칙 나열이 아니라 ’왜 이 문제가 발생하고 어떻게 접근해야 하는지’를 서술합니다.
- 복사해서 바로 실행할 수 있는 명령어 스크립트를 포함할 것: 에이전트가 파라미터만 채워 바로 터미널에 던질 수 있는 완성된 명령어를 제공해야 합니다.
- 스킬 자체에 대한 평가 세트(Eval)를 구축할 것: 스킬을 수정할 때마다 과거의 케이스들을 돌려보며 회귀(Regression)가 일어나지 않는지 확인해야 합니다.
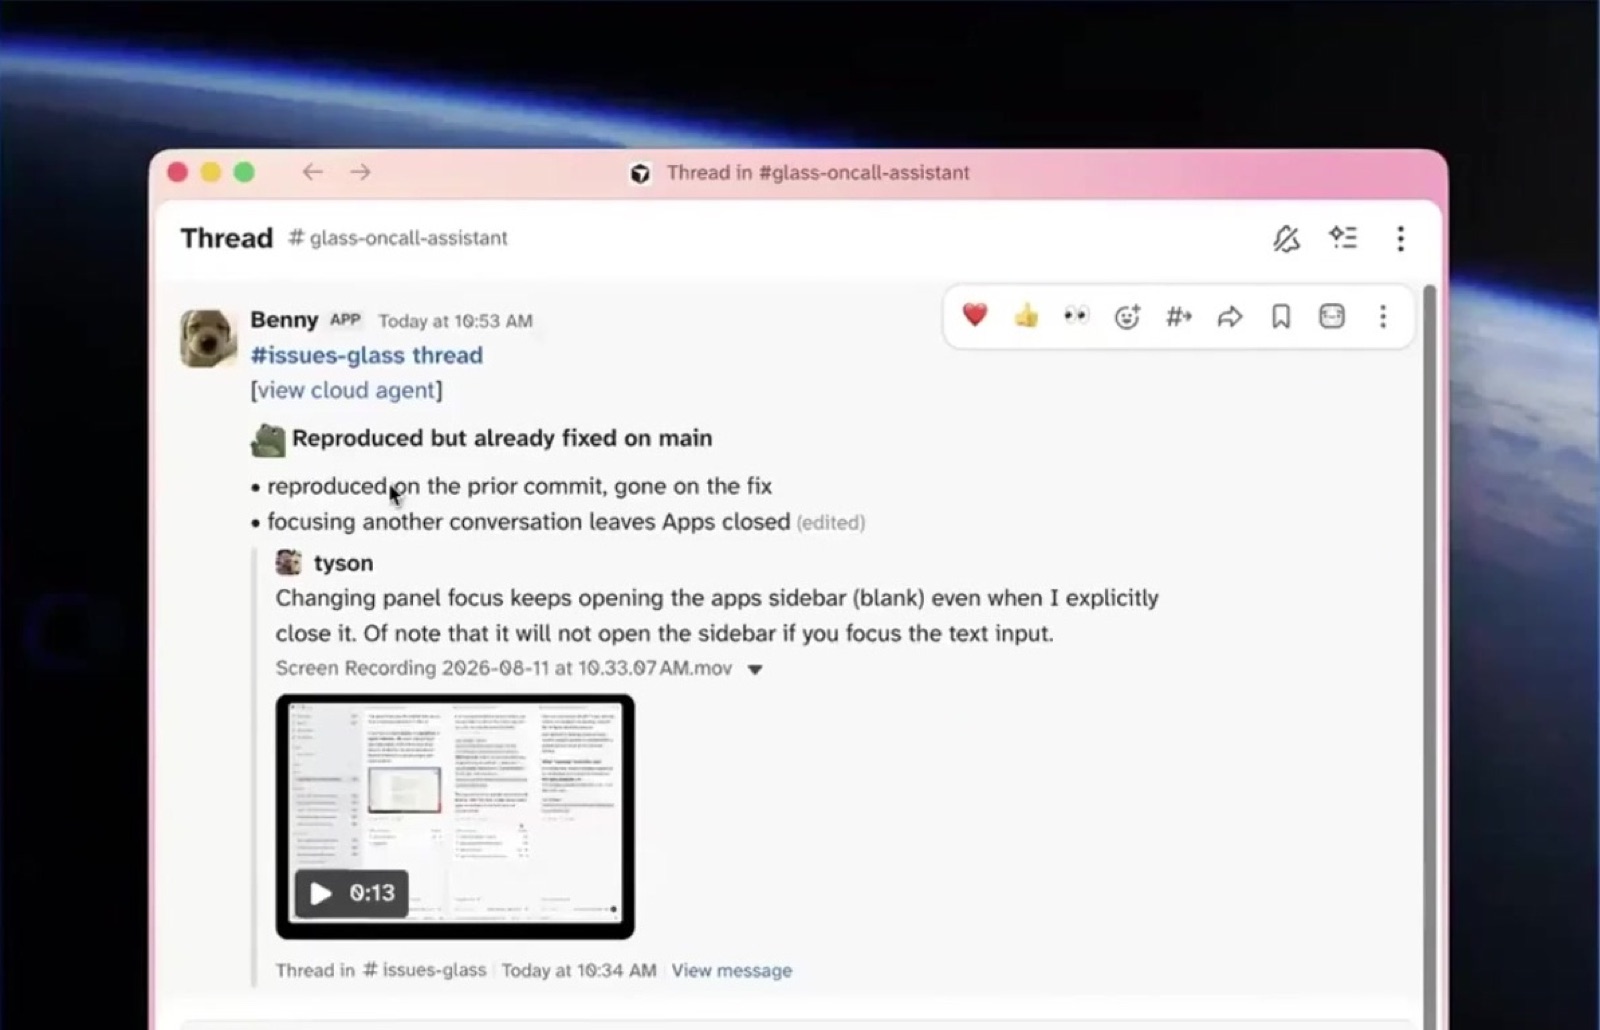
그녀가 밝힌 기막힌 디테일 중 하나: “평가(Eval) 프롬프트 안에서 에이전트가 자신이 지금 채점받고 있다는 사실을 눈치채지 못하게 위장해야 합니다.” 에이전트가 자신이 테스트받고 있다는 것을 알게 되면 평소 실작업 때와 다른 모범 답안 모드로 전환되기 때문입니다.
5. 세 번째 기반: 에이전트 친화적인 아키텍처 (Dune)
그녀가 Grok Bot을 개발하면서 설계한 아키텍처의 이름은 듄(Dune)입니다.
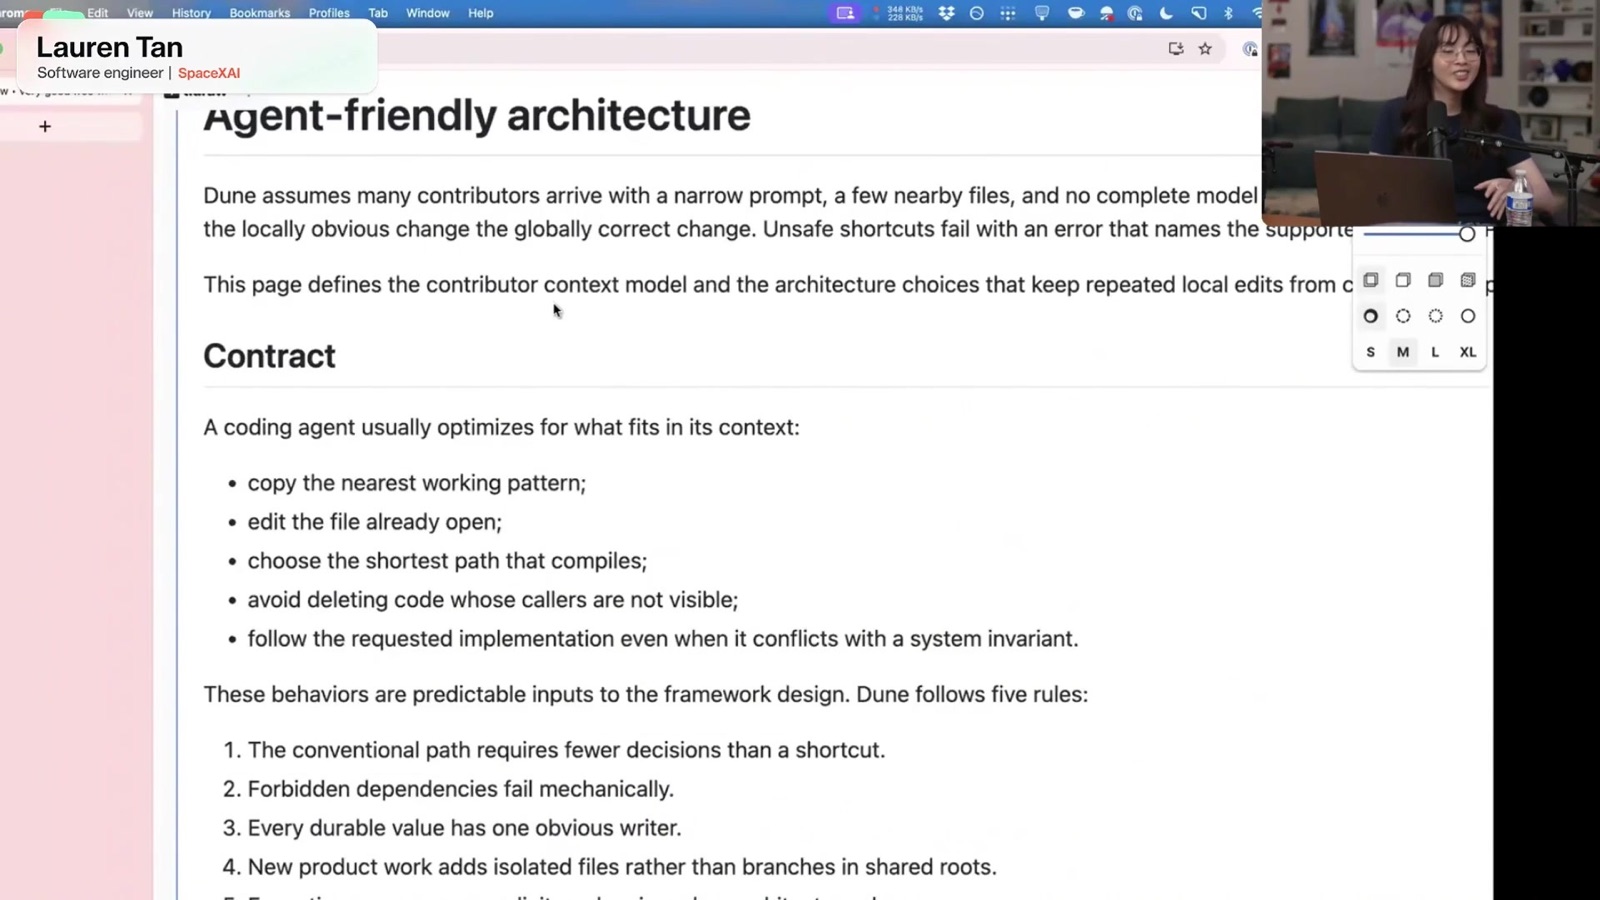
이 아키텍처의 핵심은 극도로 엄격한 단방향 의존성입니다. 시스템을 여러 레이어로 쪼개고, 상위 레이어는 하위 레이어만 참조할 수 있도록 엄격한 ESLint 규칙과 TypeScript 컴파일러 체크를 걸었습니다. 에이전트가 편법으로 레이어를 건너뛰거나 순환 참조를 만들려고 하면 CI 빌드가 가차 없이 실패합니다.
이러한 엄격한 아키텍처가 구축되면, 주니어 개발자나 에이전트가 코드를 작성하더라도 전체 시스템의 아키텍처가 무너지는 일이 물리적으로 불가능해집니다.
6. 제약의 5단계 레이어
그녀는 코드베이스의 제약 조건을 5개 레이어로 정의했습니다:
- 코드베이스 자체의 구조와 엄격한 설계
- 정적 분석: Linter, 컴파일러, CI 자동화 파이프라인
- 룰 파일 및 Bugbot (자동 코드 리뷰어)
- 스킬(Skills)
- 스타일 가이드
Dune 아키텍처의 5가지 룰과 수기 작성된 제약 레이어
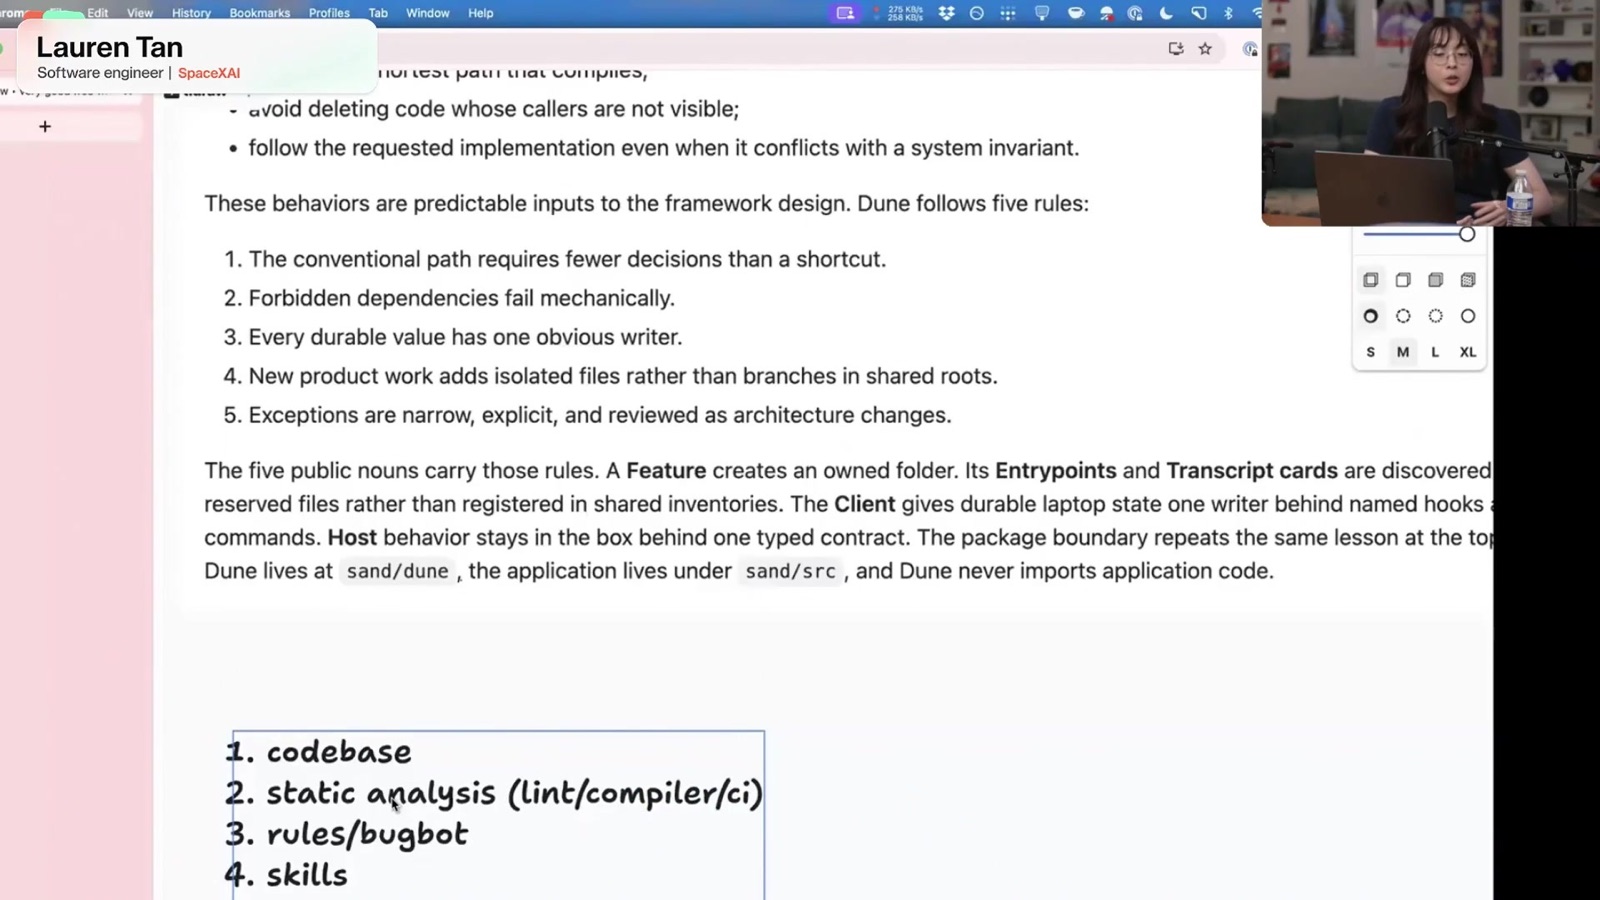
앞의 1번과 2번 레이어가 ’하드 제약(Hard Constraints)’입니다. 위반하면 빌드가 깨지고 머지가 차단됩니다. 뒤의 세 레이어는 ’소프트 제약(Soft Constraints)’으로, 에이전트가 망각하거나 누락할 수 있습니다.
그녀의 조언은 명쾌합니다: 만약 1, 2번 없이 3, 4, 5번에만 의존하고 있다면 코드베이스가 쓰레기장으로 변하는 것은 시간문제입니다.
코드 리뷰에서 지적할 내용이 생길 때마다 스스로에게 물어보세요:
- “이걸 린트 규칙으로 자동 검출할 수 없을까?”
- “이 실수가 나왔을 때 CI가 즉시 빨간불을 띄우게 만들 수 없을까?”
- “애초에 이런 실수를 컴파일 타임에 불가능하게 만드는 타입 시스템을 설계할 수는 없을까?”
PR은 철저히 작게 쪼개기
그녀의 PR은 대부분 50줄에서 수백 줄 단위로 잘게 쪼개져 있습니다. 에이전트에게 작업을 시킬 때도 하나의 거대한 태스크를 여러 개의 독립된 PR로 분할하도록 지시합니다. Git 커밋 히스토리 자체가 소중한 컨텍스트가 되며, 만에 하나 버그가 발생해도 즉시 롤백할 수 있기 때문입니다.
그녀가 시연한 PR 목록: CI 실패, 머지 완료, 클로즈 내역
7. 토큰 비용, 과연 남는 장사인가?
세션에서 가장 많이 나온 질문: “우리는 AI 연구소가 아닌데 그렇게 무제한으로 토큰을 펑펑 쓰는 게 현실적인가요?”
그녀는 솔직하게 인정했습니다. 본인은 AI 랩 소속이라 토큰 제한이 없었기 때문에 가능한 측면도 있었다고요. 하지만 이것을 철저한 투자 대비 수익률(ROI)의 관점에서 봐야 한다고 강조했습니다.
에이전트 없이 사람 혼자서 이 방대한 리팩토링과 테스트 슈트 구축, 아키텍처 재설계를 수행하려면 최소 수년의 시간과 고액 연봉의 시니어 엔지니어 인건비가 들어갑니다. 그 비용에 비하면 토큰 비용은 극히 일부에 불과합니다.
게다가 단단한 하네스와 검증 스크립트가 갖춰지고 나면, 최상위 고가 모델 대신 더 가볍고 저렴한 중소형 모델을 물려도 코드를 빈틈없이 짜냅니다. 토큰 몇 푼을 아끼려다 사람의 귀중한 시간을 검증 노가다에 낭비하지 마세요.
8. 비개발자도 기여하는 팀의 미래
그녀가 가장 고무적으로 느낀 부분은, 이 견고한 하네스 덕분에 기획자(PM), 디자이너, 마케터 같은 비개발 직군 동료들도 직접 리포지토리에 PR을 올려 버그를 고치기 시작했다는 점입니다.
PM이 “여기 작은 UI 버그가 있어서 에이전트 시켜서 고쳤어요” 하고 PR을 올리면, CI와 검증 스크립트가 모든 안정성을 보장해 주므로 안심하고 승인할 수 있는 상태가 된 것입니다.
내일부터 당장 적용할 수 있는 4단계
- 내 애플리케이션을 에이전트가 직접 띄우고 조작할 수 있는 최소한의 검증 스크립트를 만드세요. 로컬에서 화면을 캡처하고 로그를 수집하게 하세요.
- 검증 스크립트에 기능 지도를 붙여주세요. 화면 진입 경로를 파일별로 정리하세요.
- 에이전트에게 같은 실수를 지적할 때마다 그것을 하나의 재사용 가능한 Skill로 승격시키세요.
- 코드 리뷰에서 지적한 문제를 린트 규칙이나 CI 실패 조건으로 영구 박제하세요.
모델은 몇 달마다 계속 바뀝니다. 하지만 여러분이 구축해 둔 검증 환경, 스킬, 하네스는 새로운 모델이 나와도 영원히 작동하는 가장 강력한 자산으로 남습니다.
여러분은 지금 몇 대의 에이전트를 동시에 돌리고 계신가요? 신뢰 곡선의 어느 지점에 머물러 계신가요?