目次
9月15日、TypeSafe AIが「Jev」という新しいモデルを発表しました。ここ数日、開発者コミュニティで大きな話題を呼んでいます。なぜなら、このモデルはテキストを一切生成しないからです。私たちが普段使っているChatGPT、Claude、Geminiなどは一文字一文字トークンを紡ぎ出すように答えますが、Jevはそうではありません。プログラム内のデータと選択肢を定義した設問を渡すと、すべての回答とその確率(信頼度スコア)を一括で返してくれます。
例えるなら、一般的な大規模言語モデル(LLM)が「小論文を書いている」のだとすれば、Jevは「マークシートの解答用紙を塗りつぶしている」ようなものです。Jevとは何者なのか、どう使うのか、なぜ爆速なのか、人々は何を作っているのか、そしてどんな落とし穴があるのかを余すところなく解説します。
開発したのは誰か?
創業者はDiogo Almeida氏。かつてOpenAIやGoogle Brainに在籍し、InstructGPT、RLHF(人間のフィードバックによる強化学習)、ChatGPT、GPT-4などの開発に携わってきた人物です。大規模モデルに「会話」を教え込んだ張本人の一人が、今度は「一切会話をしないモデル」を作るために独立したというのは、なんとも皮肉で興味深いところです。
発表時の投稿で、彼はこう問いかけています。「LLMが人間以上に上手に会話できるようになって久しいが、本来期待されていた自動化は一体どこへ行ったのか?」と。同社はDCVCをリード投資家として4,000万ドルのシード資金を調達し、サンフランシスコを拠点にチームを展開しています。
名前の由来
彼らはこの種のモデルを、ダニエル・カーネマンの『ファスト&スロー』にちなんで「システム1(System 1)」と呼んでいます。システム1とは、脳の直感的で瞬発的な判断のことです。ソフトウェアにおける意思決定の多くは「この問い合わせのカテゴリは何か」「緊急度は高いか」といった単純な判断であり、私たちはこれまで、そうした処理に対して高価で思考速度の遅いLLMに大金を払ってきたのではないか、という問題提起です。
「Jev」という名前は、経済学者のジェボンズ(Jevons)に由来します。「ジェボンズのパラドックス」とは、蒸気機関の石炭利用効率が向上した結果、石炭の消費量が減るどころかかえって爆発的に増加したという現象です。TypeSafeも同じ賭けに出ています。知能のコストを10分の1に引き下げれば、利用される場所は100倍に広がるはずだ、という思想です。
2つのモデルが同じメッセージにどう答えるか
例えば、オンラインショップを運営していて、カスタマーサポートにこんな問い合わせが届いたとします。「届いたばかりの新品ヘッドホンの箱が潰れていて、左耳から音が出ない。返金してくれ」。
これを従来のLLMに渡すと、こんな文章が返ってきます。「本件は製品の品質および配送時の梱包に関する問題であり、購入者は憤慨しています。優先度を上げて返金処理を開始することを推奨します」。文章としては完璧ですが、プログラムは直接これを理解できません。文章をパースするコードを書くか、JSON形式で出力するよう指示して「余計なカンマが入らないか」「勝手なフィールドを捏造しないか」と祈る必要があります。
プログラムが真に必要としているのは次の3つだけです。「カテゴリは何か」「ユーザーはどれくらい怒っているか」「返金すべきか」。Jevはこの3つの値を、確率スコア付きでダイレクトに返します。
あらかじめ選択肢を定義しておけば、モデルはその中から選ぶことしかできません。小論文を語り出したり、見たこともない新カテゴリを勝手に作り出したりするリスクは原理的にゼロです。
設問タイプはわずか3種類
JevのAPIには、設計思想として意図的に3種類の設問タイプしか用意されていません。
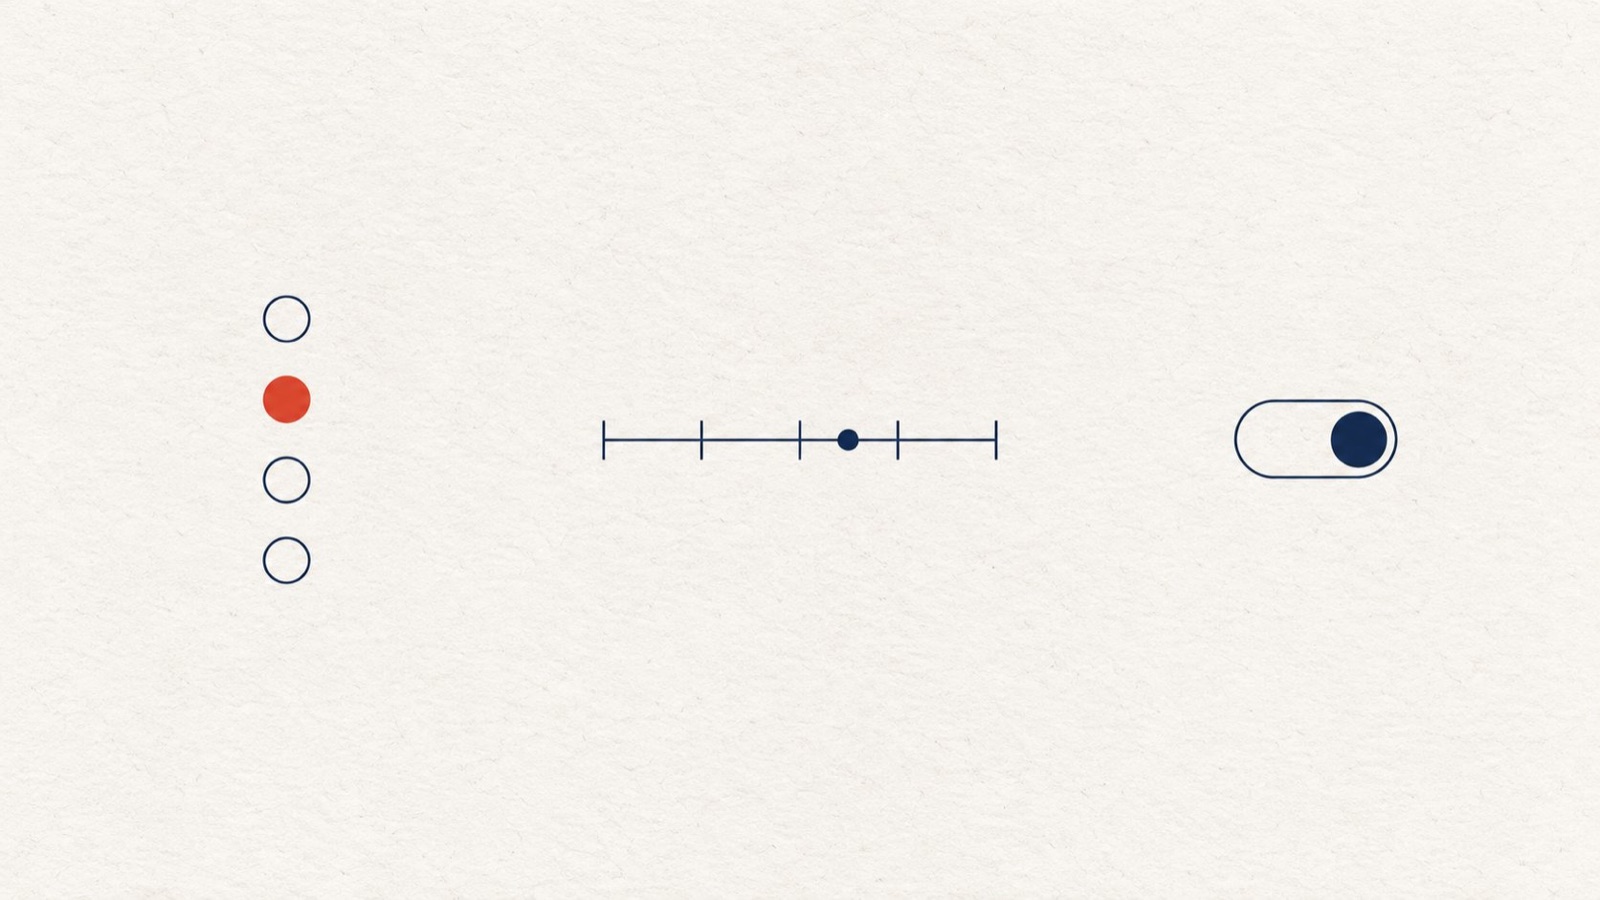
1つ目はChoice(単一選択)。最大255個の選択肢から1つを選びます。例えば「このチケットは財務、エンジニアリング、営業のどこに割り振るべきか?」といった設問です。必ず「その他」の選択肢を入れておく必要があります。さもないと、どれにも当てはまらない時に無理やり一番近い不正解を選んでしまうからです。
2つ目はScore(スコアリング)。いくつかの段階を自然言語で説明すると、入力がどの位置にあるかを「1.035」のような小数値で返してくれます。例えばユーザーの怒り度合いを「冷静」「イラついているが抑えている」「激怒している」といった基準で評価します。
3つ目はNoul(Yes/No判定)。0〜1の実数値を返し、「Yes」である確率を示します。
1回のリクエストに大量の設問を詰め込むことができ、すべて並列で一括計算されます。設問を1つ追加してもコストはごくわずかしか増えず、レスポンス時間はほとんど変わりません。
コードの実際
公式のPythonおよびTypeScript SDKが提供されています。先ほどのサポート問い合わせを処理するコードは、おおむね以下のようになります。
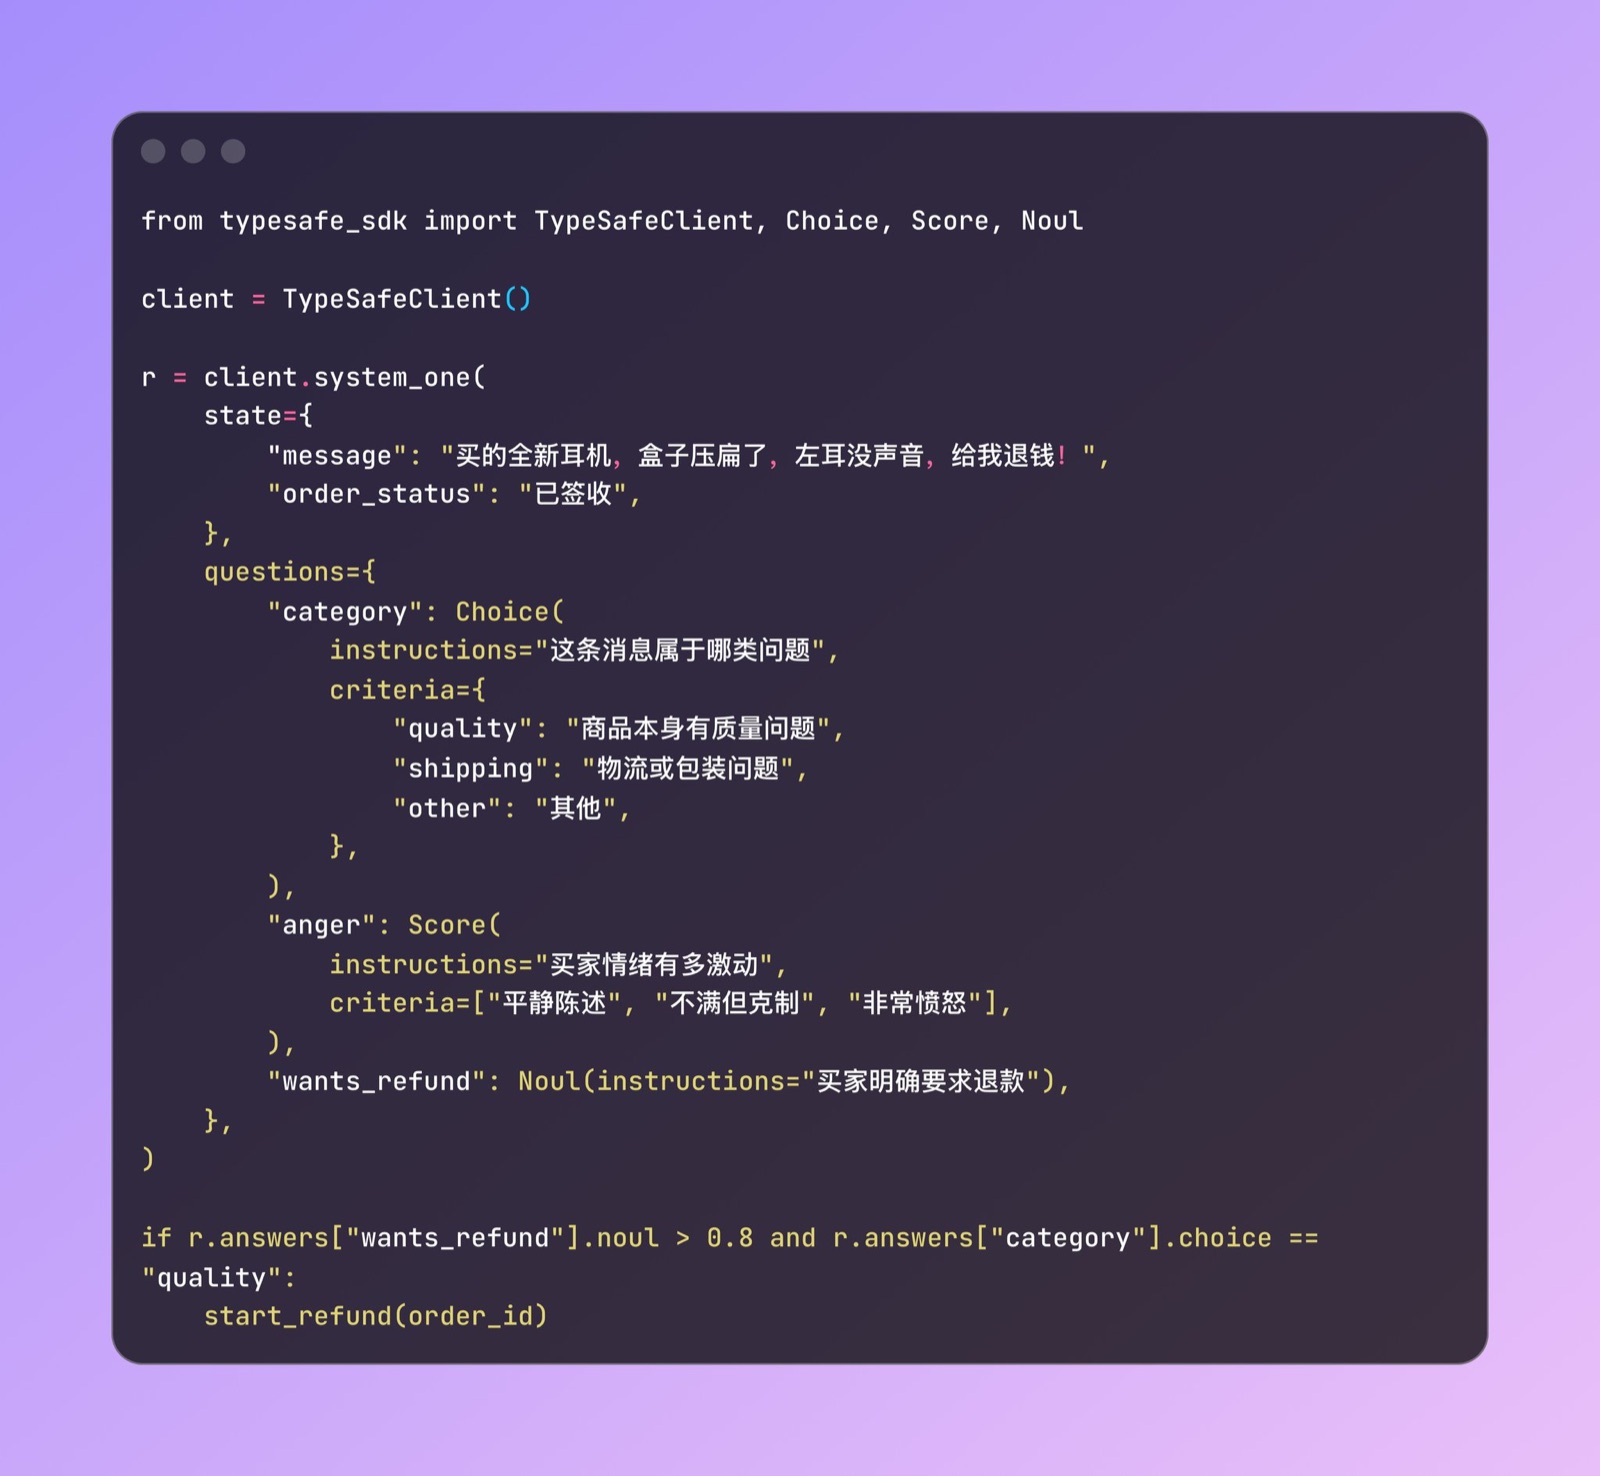
最後のif文に注目してください。Jevが行うのはあくまで「判断」であり、返金を実行するかどうか、いくら返金するかはプログラム側のコードが決めることです。TypeSafeはこれを「インテリジェントなif文(intelligent if statement)」と呼んでいます。従来ならルール化が難しかった曖昧な定性判断を、そのままコードの条件分岐に組み込めるようになったのです。
なぜこれほどまでに高速なのか?
従来のLLMがJSONを出力する場合でも、本質的にはトークン単位の逐次生成(Token-by-Token)です。中括弧、引用符、フィールド名の1文字1文字が前の文字を待って順次計算されます。一方、Jevはテキストを一切生成せず、1回のフォワードパスですべての設問を並列計算します。TypeSafeの公表データによると、エンドツーエンドのレイテンシは70〜500ミリ秒。同等のタスクで最先端フロンティアモデルが3秒〜300秒以上かかっているのと比べると桁違いです。
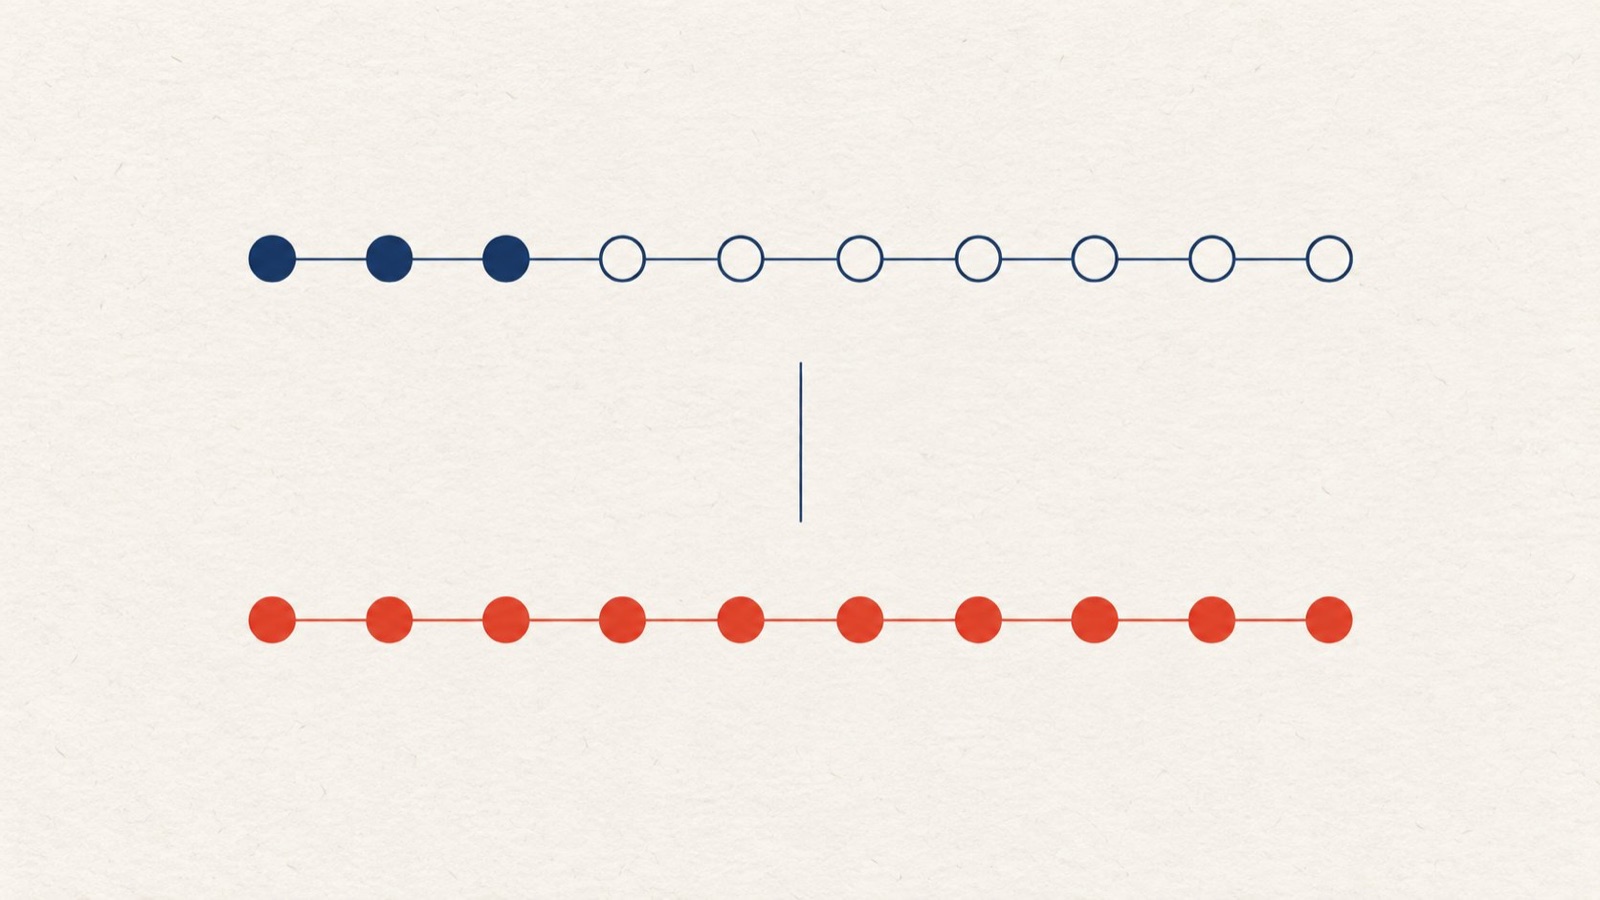
コストはさらに衝撃的です。100万トークンあたり0.042ドル(約6円)。GPT-4o(5ドル/100万トークン)の100分の1以下、Claude 3.5 Sonnet(3ドル/100万トークン)の70分の1以下です。判断1回あたり数千分の一円という水準であり、これまでコスト的に諦めていた処理にも惜しみなく投入できます。
開発現場での活用事例
まだ登場したばかりですが、エンジニアたちはすでに様々な用途を試し始めています。
- カスタマーサポート自動化: メールやチケットの仕分け、感情分析、緊急度判定をミリ秒単位で実施。
- データラベリング・データクレンジング: 何十万行ものCRMや非構造化データを一気にカテゴリ分類。
- コンテンツモデレーション: スパム、攻撃的な発言、規約違反コンテンツのリアルタイム検知。
- スマートルーター: ユーザーの質問の難易度をJevで瞬時に判定し、簡単なものは軽量オープンモデルへ、高度な推論が必要なものだけを高価な推論モデルへルーティング。
気をつけるべき制約と落とし穴
Jevは魔法の万能薬ではありません。明確な得手不得手があります。
第一に、設問の書き方です。選択肢の説明は極めて具体的である必要があります。人間が「言わなくても分かるだろう」と思うニュアンスは伝わりません。質問文に曖昧さがあると、精度は一気に落ちます。
第二に、数え上げ(Counting)や日付の計算が苦手です。「リストの中に何個あるか」を正しく数えることはできません。数えたい場合は各要素に対してYes/Noを判定させ、コード側で集計するのが正解です。また「どちらが先か」「何日離れているか」といった日付の計算も信頼できません。日付の抽出だけを行わせ、差分計算はコードに任せるべきです。
第三に、入力が無関係なノイズだらけだと精度が落ちるため、事前にコードで不要なテキストを間引いてから渡す必要があります。またプロンプトインジェクションに対する防御層を持たないため、ユーザーからの直接入力をそのまま渡すと誤判定を誘発されるリスクがあります。そして当然ながら、文章やコードの要約・生成は一切できません。
公式ドキュメントにある「コードで正確に計算できることをモデルに聞くな。1つの設問に複数の判断を詰め込むな」という一言は、非常に示唆に富んでいます。
「200倍高速」という数字の受け止め方
ベンチマークで「100倍」「200倍」「400倍」といった数字を目にしたことがあるかもしれません。最も極端な数字はTypeSafe自社の社内ベンチマーク(193.6倍高速、444.6倍安価)によるもので、同社自身も「実環境ではここまで極端な差にはならない」と認めています。
その検証において、Jevのスコアは67.8%、GPT-5.6 Terraは67.9%とほぼ同等でした。ただし、このスコアは客観的な正解率(Accuracy)ではなく、GPT-6 AstraとFable 5.1の合議判定との一致度を測ったものです。設問作成もテストも自社で行われたものであり、現時点で第三者による追試は完了していません。
また「ハルシネーション(幻覚)がない」という謳い文句にも注釈が必要です。事前に用意した選択肢以外を勝手に捏造しないという意味では真ですが、「誤った選択肢を選んでしまう(誤判定)」は当然起こり得ます。
コミュニティの冷静な視線
エンジニアのSean Goedecke氏は、説得力のある分析記事を寄稿しています。既存のLLMでも、回答の頭をあらかじめ埋め込んで(Prefill)残りの1トークンを選択肢の語彙だけに制限(Logit Bias/Constrained Sampling)すれば、同様の高速化はかなり達成できると指摘しています。実際、コミュニティではすでにオープンソース版の「openjev」が開発され、4Bクラスのオープンモデルを用いて1パスでの並列判定を実現しています。
またJevは回答前に「思考(Reasoning)」を挟むことができないため、推論時計算量(Inference-time Compute)の恩恵を受けられず、知能の上限は非推論モデルと同等にとどまります。
いつ使うべきか?
最適なユースケース:
- チケットの分類・ルーティング
- コンテンツモデレーション(規約違反チェック)
- 高価なモデルへ渡す前段のフィルタリング
- LLM出力のリアルタイムなスコアリング・ゲートウェイ
- コストが理由で見送っていた大規模データセットの自動ラベリング
- 1秒以内のレスポンスが必須のUI/UX判断
不向きなユースケース:
- 文章やコード、要約の生成
- 要素のカウントや日付の差分計算
- 人間向けの根拠説明文が必要な意思決定
- 複雑な多段階推論を要するタスク
- 事前に選択肢を網羅できない自由回答
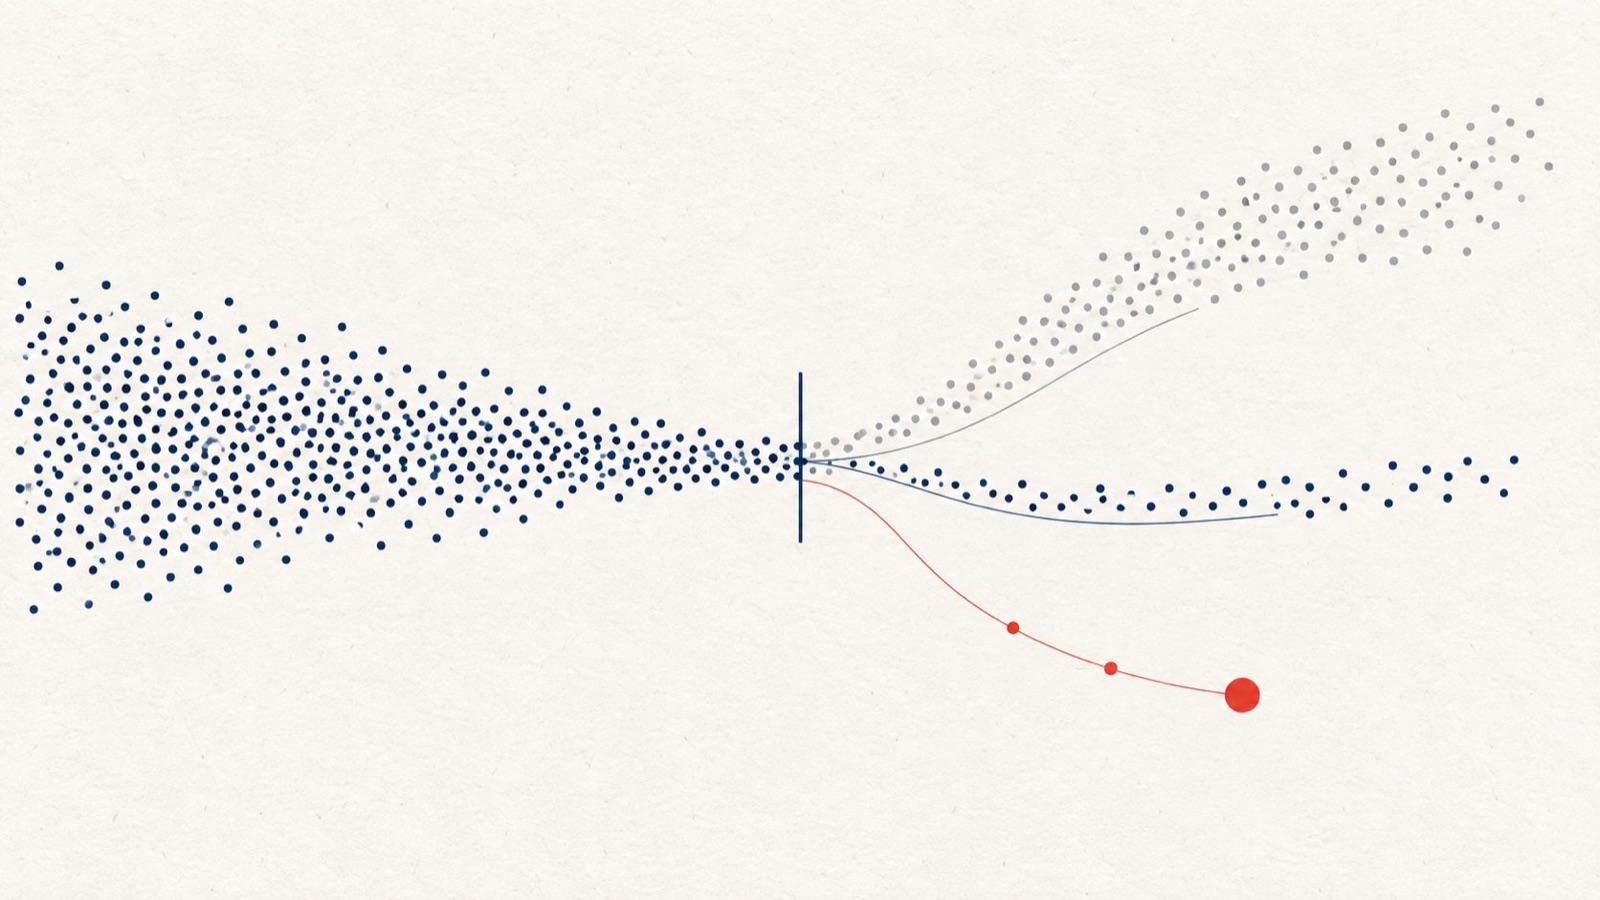
最も実用的なパターンは「階層化(Tiering)」です。まずJevでリクエストの種別と難易度を瞬時にトリアージし、単純なものは既存コードや安価なモデルで処理し、本当に難解なケースだけを最高峰の推論モデルに回す。LangChainもすでに統合ガイドを公開しており、エージェントのツール呼び出し(Tool Calling)が危険でないかをJevに事前審査させるパターンなどが紹介されています。
まとめと所感
Jevを見て最も強く感じるのは、「インターフェースのあり方そのものの転換」です。ここ数年、LLMを使ったプロダクトのほぼすべてがチャットボックス(対話型UI)の形をとってきました。しかし、100ミリ秒で答えを返し、コストがほぼゼロで、判断の信頼度(確率)まで教えてくれる判定関数が登場したことで、チャットボットとは似ても似つかない全く新しいAIアプリケーションの潮流が生まれる可能性があります。
私たちがこれまで「高価なLLMに考えさせていた仕事」の多くは、実のところ単なる「多肢選択問題」に過ぎなかったのではないか——そんな気づきを与えてくれる意欲作です。