9 月 15 号 TypeSafe AI 发了个新模型叫 Jev,这几天开发者圈子讨论挺多的,因为它压根不生成文字。你平时用的 ChatGPT、Claude、Gemini 回答问题都是一个字一个字往外蹦,Jev 不这样。你给它一段程序里的数据,再出几道选项定好的题,它一口气把所有答案连同概率一起交回来。
打个比方,普通大模型在写作文,Jev 在填答题卡。下面把它是什么、怎么用、快在哪、大家拿它做了啥、有什么坑一次讲清楚。
那么这个是谁做的呢?
创始人叫 Diogo Almeida,之前在 OpenAI 和 Google Brain 待过,InstructGPT、RLHF、ChatGPT、GPT-4 他都参与过。当年把大模型调教得会聊天的就有他一个,结果他自己出来做了个不聊天的模型,挺有意思的。
他在发布文里问了一句,模型聊天早就比人强了,那自动化到底去哪了。公司拿了 4000 万美元种子轮,DCVC 领投,团队在旧金山。
名字怎么来的
这类模型他们叫 System One,取自卡尼曼那本思考快与慢。系统 1 就是人脑里那种不过脑子的快速判断。他们觉得软件里大部分决策都是这种题,比如这属于哪类、这急不急,以前我们一直在花大钱请慢思考的大模型来答。
Jev 这个名字来自经济学家杰文斯。杰文斯悖论说的是蒸汽机越省煤,煤反而烧得越多。TypeSafe 赌的也是这个,智能便宜十倍,用它的地方会多一百倍。
同一条消息两种模型怎么答
假设你开网店,客服后台来了一条消息,买的全新耳机盒子压扁了,左耳没声音,给我退钱。
丢给普通大模型,它会回你一段话,大概是该问题涉及商品质量和物流包装,买家情绪激动,建议优先处理并启动退款。写得挺好,可程序看不懂啊。你还得再写代码去拆这段话,或者让它吐 JSON,然后祈祷它别哪天多打个逗号或者自己编个新字段。
程序真正要的就三样,归哪类、买家多生气、是不是要退款。Jev 直接把这三个值给你,每个都带概率。
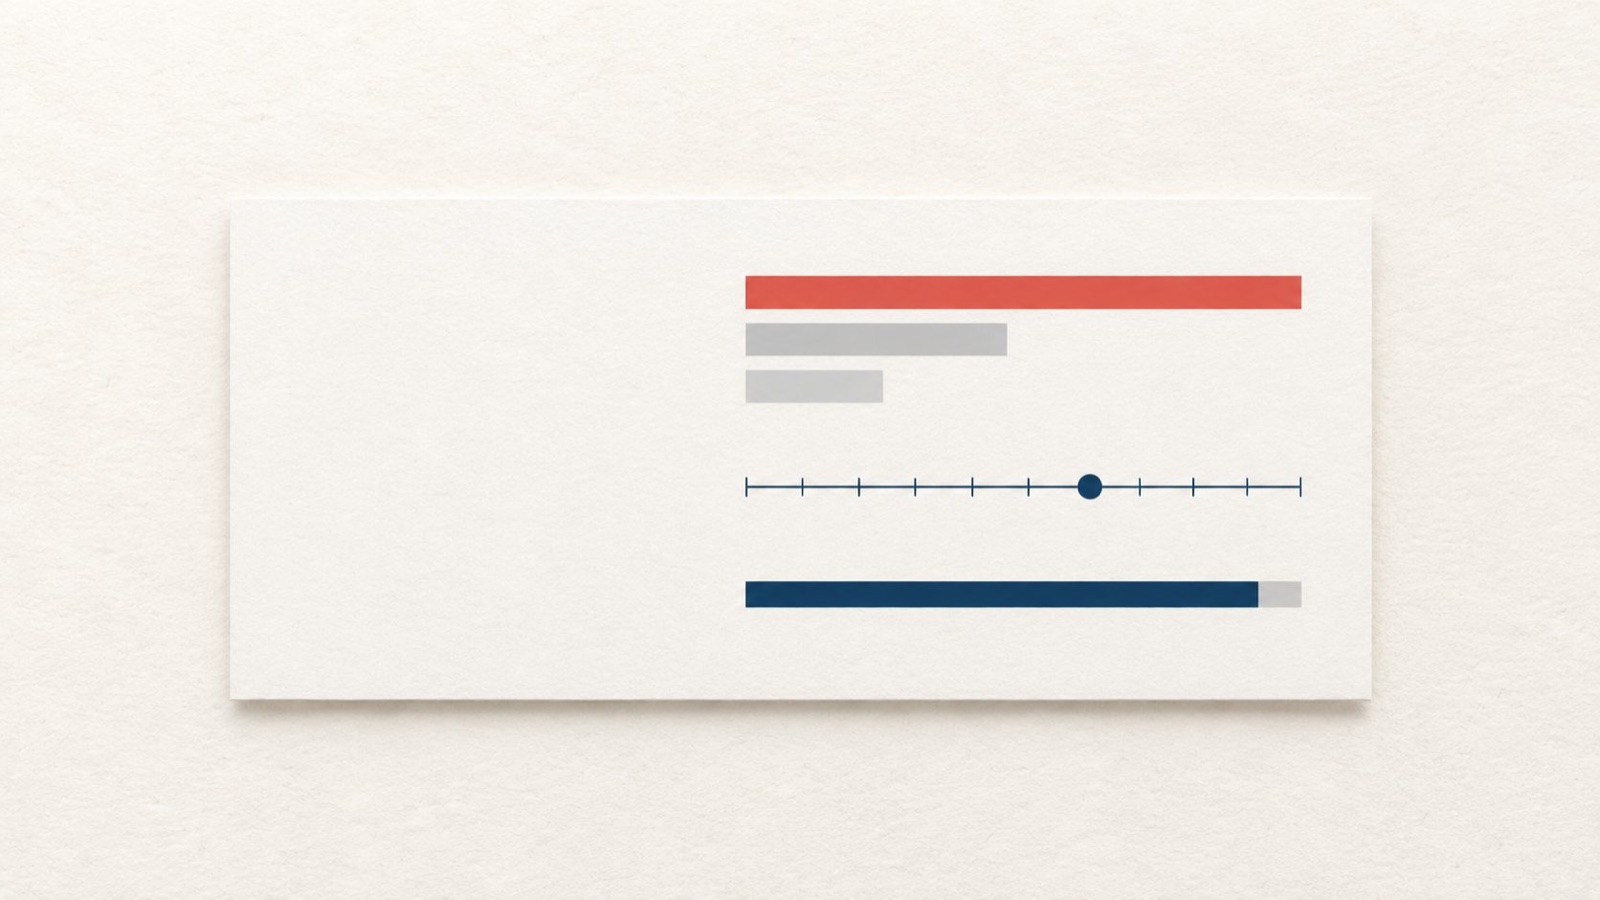
选项是你提前定的,它只能在里面挑。不会给你写小作文,也不会冒出一个你没见过的类别。
只有三种题
Jev 的接口就三种题,故意做得这么少。
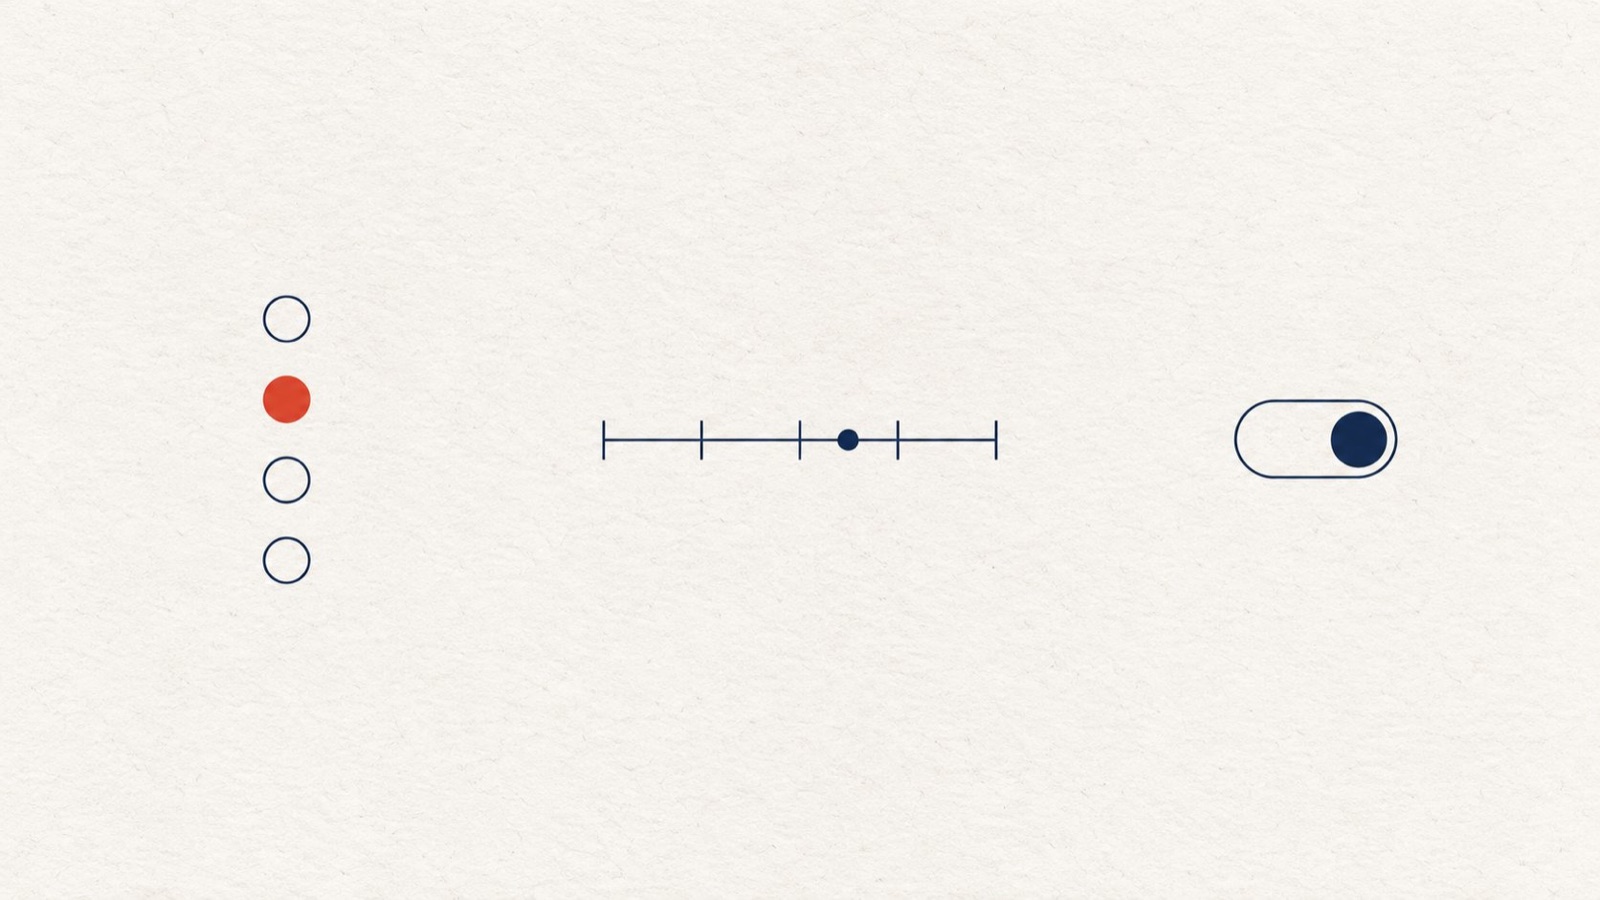
第一种叫 Choice,就是单选,从一堆选项里挑一个,最多 255 个。比如这张工单该给财务、技术还是销售。建议永远加个其他,不然都不合适的时候它会硬挑一个最像的错答案。
第二种叫 Score,就是打分。你用文字写几个等级,它告诉你落在哪,可以是 1.035 这种小数。比如用户有多生气,从平静到不满但忍着再到非常火大。
第三种叫 Noul,判断是不是,直接给你一个 0 到 1 的数,就是是的概率。
一次请求可以塞很多道题,它们是同时算的,多问一道只多花一点点钱,时间几乎不变。
代码长啥样
官方有 Python 和 TypeScript 的 SDK,把上面那条客服消息写成代码大概是这样。
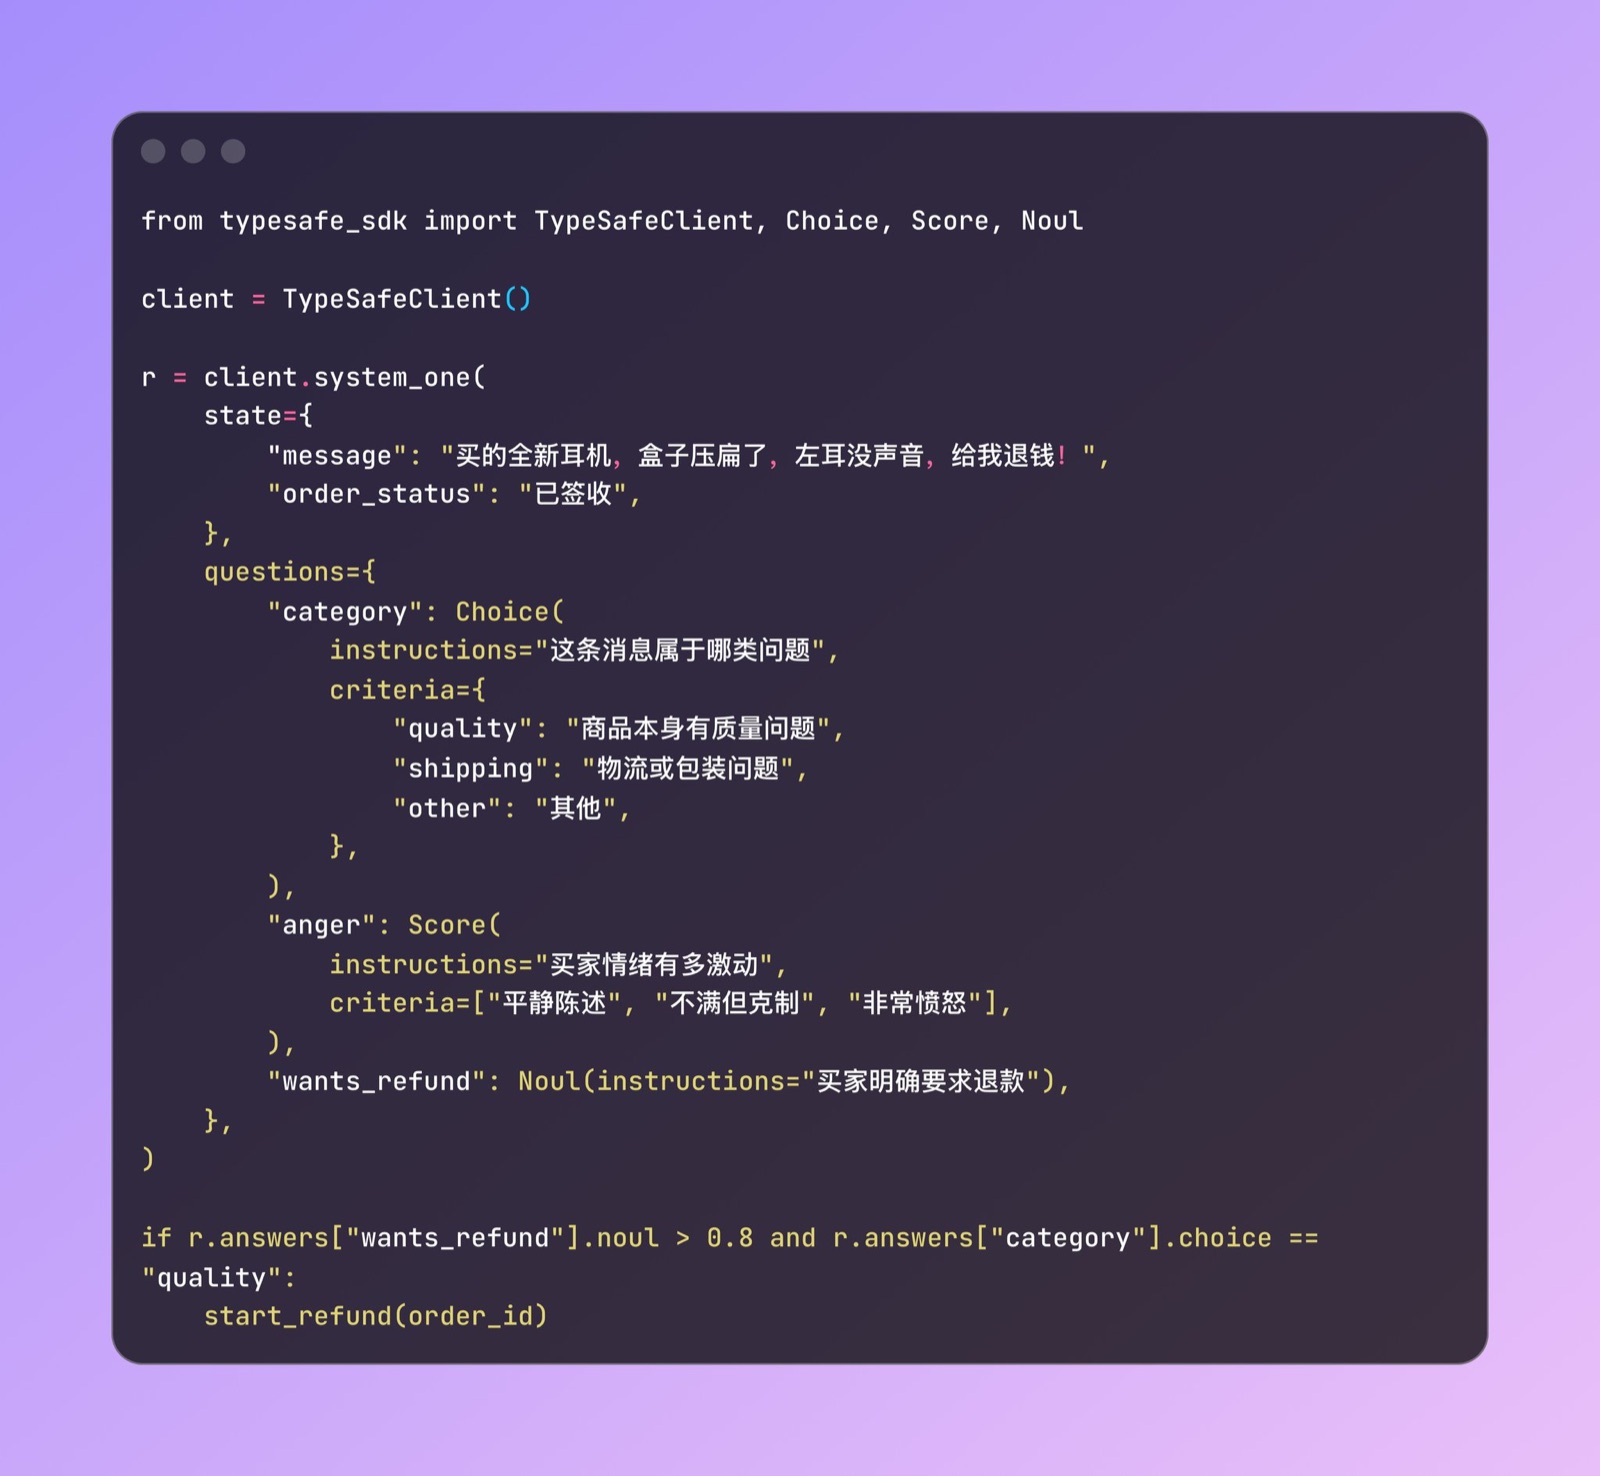
重点看最后那个 if。Jev 只管判断,真要不要退款、退多少,还是你自己的代码说了算。官方管这个叫智能 if 语句,以前那些写不出规则的模糊判断,现在能直接塞进 if 里了。
为什么这么快
普通大模型吐 JSON 也得一个 token 一个 token 地生成,大括号、引号、字段名每个都要单独算一遍,后一个等前一个。Jev 干脆不生成字了,所有题一次并行算完。官方说端到端 70 到 500 毫秒,同一张对比表里前沿大模型是 3 秒到 300 多秒。
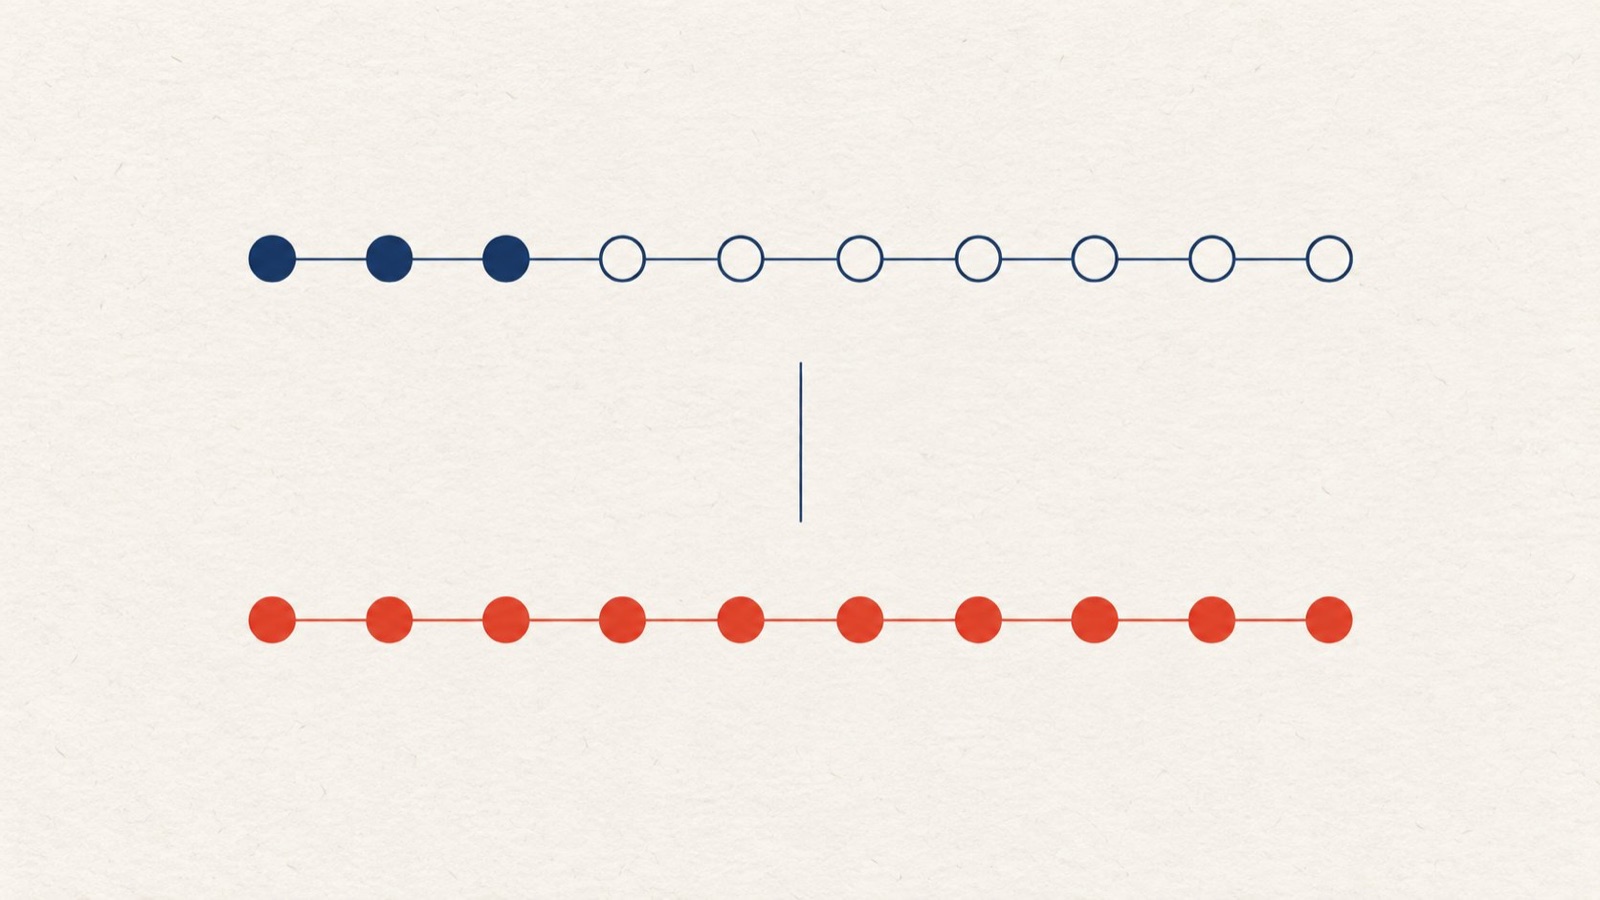
价格更夸张,输入每百万 token 0.042 美元,输出不要钱。前沿大模型输入一般是每百万 0.2 到 10 美元,输出还要再贵好几倍。按官方价格算笔账,100 万条评论,每条连题目算 500 token,一共 5 亿 token,输入费大概 21 美元。
官方还放了个 Jev 实时打 Doom 的演示,每秒决策 10 次,一小时成本 7 美元左右。不过喂给它的是文字版的游戏状态,不是画面。
真正好用的是置信度
Jev 的训练方法叫 RLCD,翻过来就是校准决策的强化学习,目标是让它的概率说实话。它说有九成把握的时候,长期看真的差不多九成是对的。
这个会改变你写程序的思路,你可以按答错的代价给每个操作设不同门槛。拿银行客服机器人举例,把握低于一半直接转人工。用户只是查余额,门槛放低点无所谓。用户要转账,动的是钱,得 85% 以上才执行,不够就弹窗让用户自己点确认。
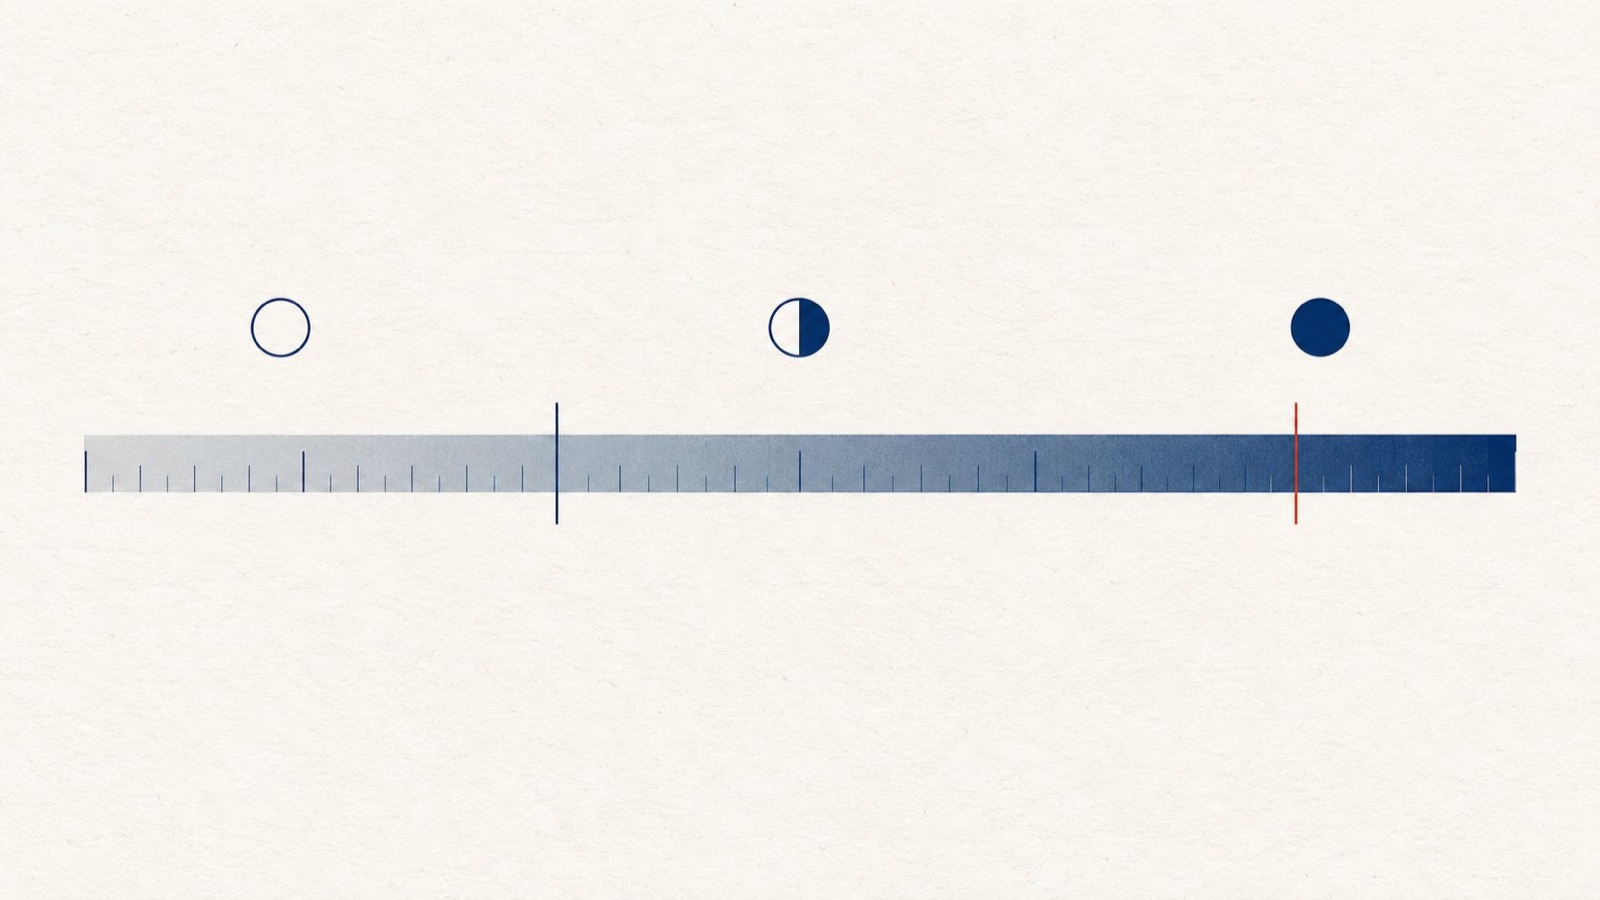
普通大模型你也能让它顺便报个把握有多大,但它们普遍太自信,嘴上说九成五,实际没那么准。
大家拿它做了啥
发布后两天社区就冒出来一堆项目,下面的数都是作者自己报的,当演示看就好。
有人拿它给 1018 篇论文分类。先用 DeepSeek V4 Flash 写摘要花了 3.99 美元,再把摘要和 24 个主题丢给 Jev 做单选,一共才 0.08 美元。
Browser Use 团队做了个浏览器 Agent。每一步把网页转成带编号的元素表,Jev 一次请求同时决定做什么操作、点哪个元素,只有要打字的时候才叫一个小模型。在真的 Google Flights 上订苏黎世飞伦敦,7.1 秒,花了 0.0039 美元。
还有人做了 Mac 自动操作,OCR 读屏幕,Jev 选下一步,每步 0.0002 美元,换成 Opus 5 直接看截图是每步 0.032 美元。作者也说了句大实话,大模型看截图就能读出日期比先后,换成 Jev 这部分得自己写代码补。
有人拿它控无人机,飞控避障全是传统代码,视觉用传统 CV,Jev 每秒只判断 2.5 次,而且只提建议,安全永远归代码管。还有人让它打通了星际争霸第一关,一共做了 421 次决策,也有人让它玩超级马里奥,喂的是模拟器内存转出来的 JSON。
这些项目思路都差不多,循环、安全、计算都留给普通代码,Jev 只管中间那一小块代码写不清楚的判断。
它的坑
TypeSafe 自己出了一页文档专门列 Jev 哪里不行,发布期就主动写这个挺少见。
它读题特别死板,否定词、范围限定、你心里默认但没写出来的条件,它全按字面理解。你要是发现自己在嘀咕我其实是想问什么什么,那半句就是题目里漏掉的。
它不会数数,东西越多越不准,要数的话就每项问一道是不是,最后用代码加起来。它也不会算日期,谁先谁后、差几天都不靠谱,让它提取就好,比较交给代码。
喂的无关内容越多它越不准,最好先用代码筛一遍,只给它问题需要的那几个字段。它也不防备输入,用户能改输入的话,一段专门写来忽悠它的文字真能把答案带偏。还有它不生成任何东西,不写字不写代码也不写摘要。
官方文档里有句话我挺喜欢,代码能算准的别问模型,一道题里别藏好几个判断。
快 200 倍这种数字怎么看
你可能在不同文章里看到 100 倍、200 倍、400 倍。最高那个来自 TypeSafe 自家的测评,快 193.6 倍,便宜 444.6 倍,官方自己也说这算现实里偏高的情况。
测评里 Jev 得了 67.8%,GPT-5.6 Terra 是 67.9%,几乎一样。Sol 74.1%、Opus 5 73.1% 都比它高。Claude Sonnet 5 也是 67.8%,但每道题成本是 Jev 的 293 倍。
可这个分数不是准确率。测评没有标准答案,参考答案是 GPT-6 Astra 和 Fable 5.1 的平均,测的其实是它跟这两个顶级模型有多像。题是自己出的,测也是自己测的,目前还没第三方复现。
不会幻觉这个说法也得打个折。它能保证的是答案一定在你给的选项里,不会瞎编,可在选项里选错照样会发生。价格也不一定一直这样,官方自己说没法证明现在没补贴,只是预计以后会更便宜。
也有人泼冷水
工程师 Sean Goedecke 写了篇分析挺有代表性。他觉得现有大模型也能做到很快的结构化输出,把回答提前填好只剩一个 token,再限制它只能从选项里挑,速度优势就拿到大半了。他自己拿 Qwen2.5-1.5B 试了下,比普通结构化输出快两三倍。
社区也已经有人照这思路做了个开源版叫 openjev,在一个 4B 开源模型上一次算完直接读选项概率。作者也说了,这只是复刻接口,不是 Jev 的模型和训练方法。
Sean 还说 Jev 没法想一想再回答,用不上推理时计算,聪明程度大概也就是非推理模型那一档。所以它护城河到底有多深现在真不好说,不过他也承认,专门为这件事训练出来的模型大概率还是比大家自己改的好用。
什么时候该用
适合的场景有工单分类和分流、内容审核、把资料塞给贵模型之前先筛一遍、给大模型的输出打分把关、以前嫌贵没做的大批量打标签,还有所有要一秒内出结果的判断。
不适合的是写任何东西、数数算日期、需要写清理由给人审的决策、一次性的复杂推理,以及答案没法提前列成选项的问题。
最常见的用法是分层。Jev 先判断这是什么请求、难不难,代码能搞定的直接搞定,普通的给便宜模型,只有少数难题才上最贵的。LangChain 已经出了接入教程,其中一个用法就是拿 Jev 检查 Agent 的工具调用有没有风险。
想试的话现在要排队申请,也能通过 Vercel AI Gateway 调。要是按置信度调好了门槛,记得把版本号固定住,jev-latest 会跟着新版本变,答案也可能跟着变。
说说我的看法
Jev 最打动我的是它换了一种接口。这几年大家在大模型上搭的东西基本都长得像个聊天框,现在有了一个 100 毫秒就回、几乎不要钱、还会告诉你该信它几分的判断函数,可能会冒出一批完全不像聊天机器人的 AI 应用。
它也让我意识到,很多以前交给大模型的活其实就是道选择题。当然它现在还在内测,关键数据都是自己测的,等第三方跑一轮再下结论也不迟。
你手上有没有哪个功能,其实只需要 AI 做道选择题?